math » 数学狂想曲(四)——统计杂谈
2017-01-14 :: 5943 Words概率分布(1)
多项分布和狄利克雷分布
伯努利试验只有两个可能的实验结果,如果实验结果的个数超过2个,那么二项分布就变成了多项分布(multinomial distribution):
\[f(x_1,\ldots,x_k;n,p_1,\ldots,p_k)=\frac{n!}{x_1!\cdots x_k!} p_1^{x_1} \cdots p_k^{x_k}\]多项分布对应的共轭先验分布是狄利克雷分布(Dirichlet distribution):
\[f \left(x_1,\cdots, x_{K}; \alpha_1,\cdots, \alpha_K \right) = \frac{1}{\mathrm{B}(\boldsymbol\alpha)} \prod_{i=1}^K x_i^{\alpha_i - 1}\tag{1}\]这里引入向量表示的贝塔函数:
\[\mathrm{B}(\boldsymbol\alpha) = \frac{\prod_{i=1}^K \Gamma(\alpha_i)}{\Gamma\left(\sum_{i=1}^K \alpha_i\right)},\qquad\boldsymbol{\alpha}=(\alpha_1,\cdots,\alpha_K)\]狄利克雷分布的密度函数如下所示(3维):
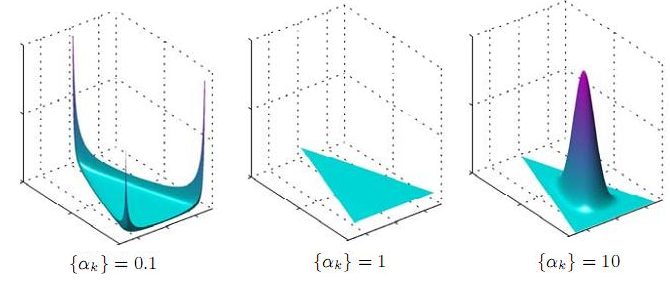
上面的图,实际上是个4维图,只不过用一个平面上的三角形代表实验结果的3维而已。这也是一种高维数据可视化的方法。
和多项分布类似的还有Categorical Distribution:
-
将一个小球放入k个桶,记变量X为k个桶内的小球个数,所以是一个向量,并且是One-hot的形式,因为这个小球只能在一个桶里面,所以是服从Categorical分布;
-
将n个小球放入k个桶,记变量X为k个桶内的小球个数,是一个向量,并且向量元素的和为n,所以是服从多项分布。
参考:
http://cos.name/2013/01/lda-math-beta-dirichlet/
LDA-math-认识Beta/Dirichlet分布
http://www.cs.cmu.edu/~epxing/Class/10701-08s/recitation/dirichlet.pdf
Dirichlet Distribution, Dirichlet Process and Dirichlet Process Mixture
https://zhuanlan.zhihu.com/p/59550457
Categorical Distribution
Tweedie分布
Tweedie分布是一种泊松分布和伽马分布的复合分布。
其重要的调节参数p,当p=1,Tweedie就是Poisson分布,当p=2,Tweedie就是Gamma分布。\(1< p < 2\)的时候就变成Poisson和Gamma的复合分布。
https://mp.weixin.qq.com/s/UAXSGp0Lx_-HvIMEH3ttLg
tweedie回归在信贷业务中的应用
https://www.zhihu.com/question/442615310
有没有大佬可以讲解一下Tweedie分布对正态、泊松、伽马分布的统一,和后三个分布间的相互转换与区别?
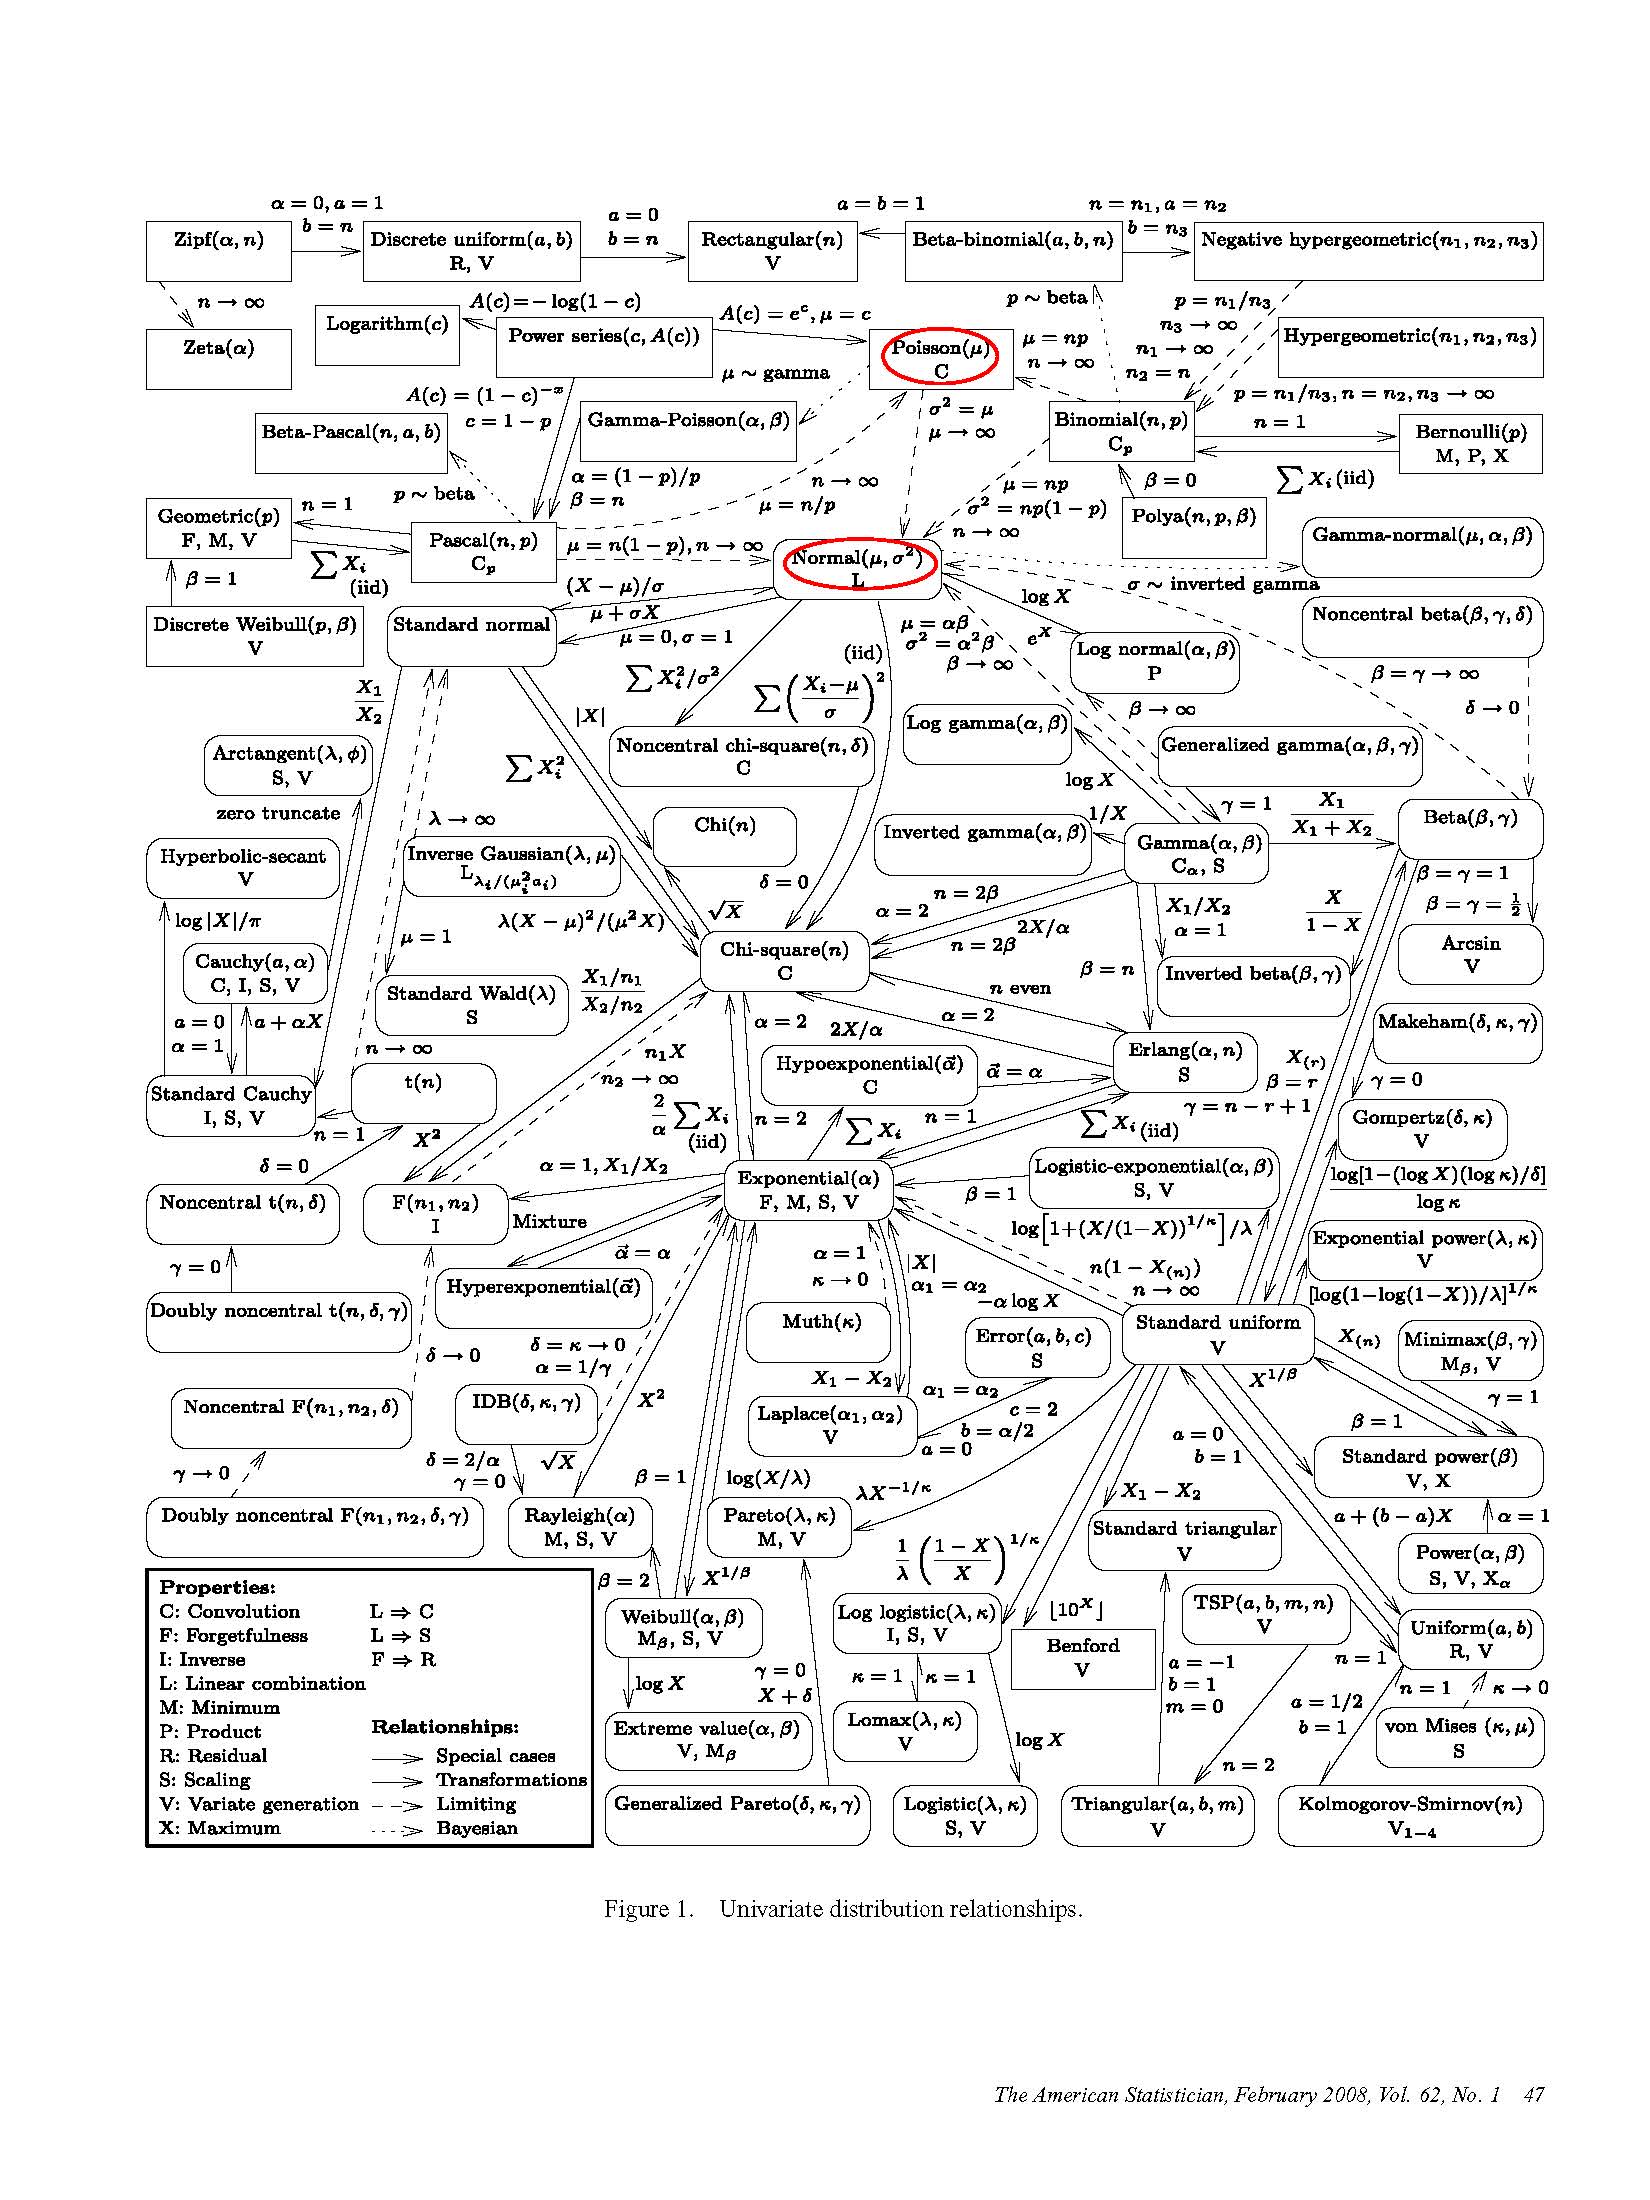
各种概率分布的关系
参考:
http://www.math.wm.edu/~leemis/2008amstat.pdf
Univariate Distribution Relationships
http://www.math.wm.edu/~leemis/chart/UDR/UDR.html
上图的网页版
http://www.wzchen.com/s/probability_cheatsheet.pdf
Probability Cheatsheet v2.0
https://mp.weixin.qq.com/s/svNVryWhiGxWFBz0s0dX5g
概率论简史
https://zhuanlan.zhihu.com/p/158801020
深度学习那些需要掌握的概率分布
统计杂谈
统计模拟
统计模拟是数理统计中非常有用的工具之一, 它是利用计算机产生某概率模型的随机数,再通过这些随机数来模拟真实模型。
这方面的书籍首推Sheldon M.Ross所著的《Simulation》。
Sheldon M.Ross,斯坦福大学统计学博士(1968),UCB教授(1976~2004),南加州大学Industrial and Systems Engineering系主任。
以下仅记录一些简单的结论。
均匀分布
通过线性同余生成器(linear congruential generator, LCG)可以生成伪随机数,且该随机数满足均匀分布。
\[x_n=ax_{n-1}\quad \mathrm{modulo} \quad m\]这里的a和m通常都是大质数。
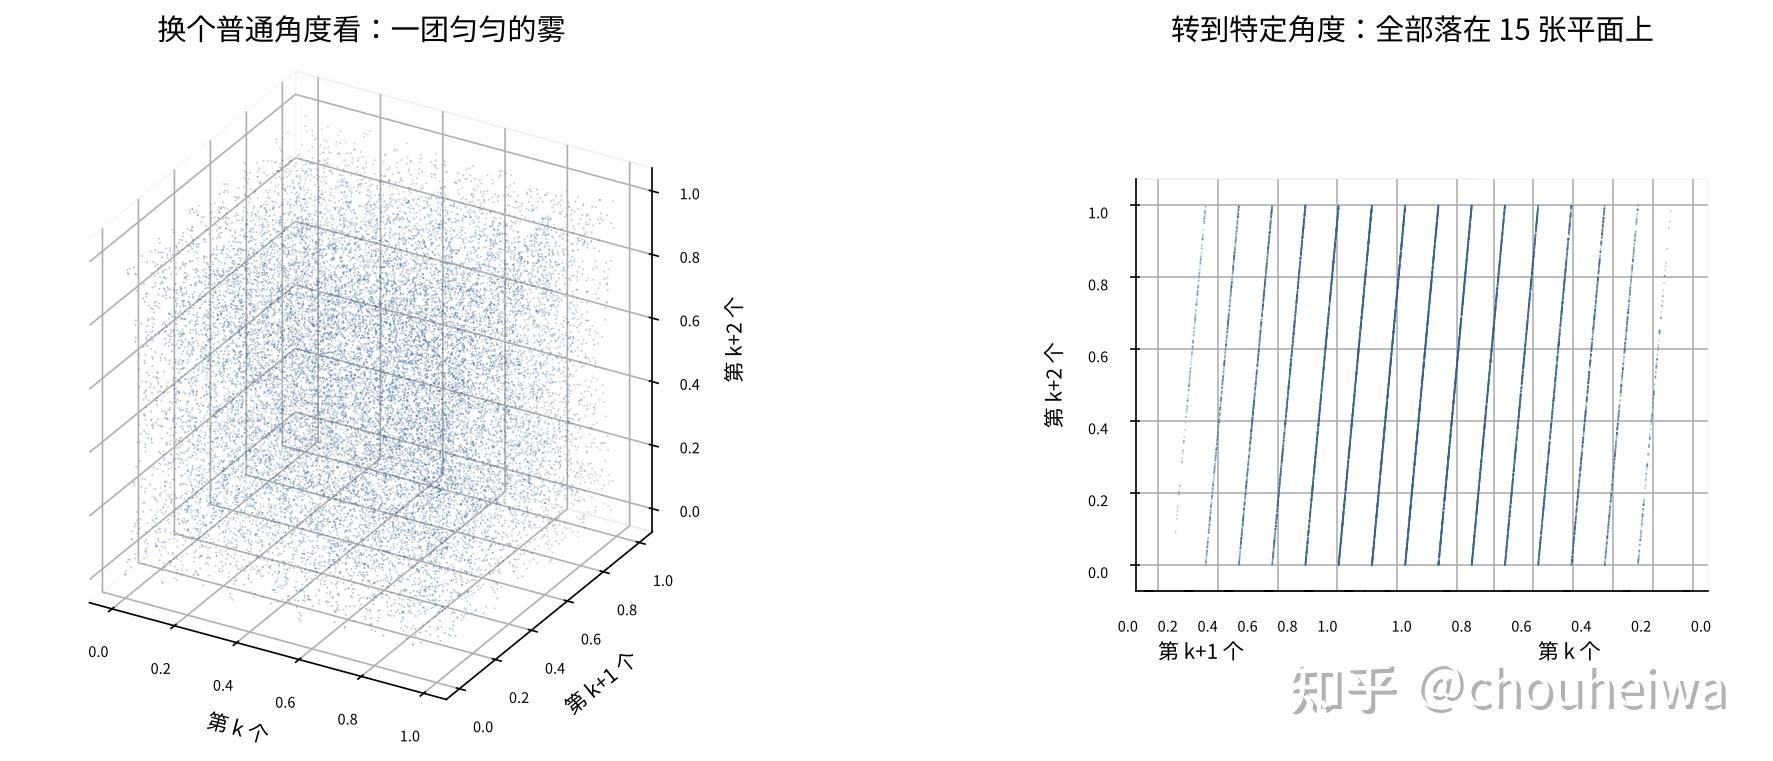
LCG的问题是:把连续三个输出当成三维空间里一个点的坐标,用一个普通角度看是一团匀匀的雾,而转到特定的角度,所有点整整齐齐码在15张薄片上,即在n维空间里的点都只落在数量相对很少的超平面上。
正态分布
Box-Muller变换:如果随机变量\(U_1,U_2\)独立且\(U_1, U_2 \sim Uniform(0,1)\),
\[\begin{align} Z_0 & = \sqrt{-2\ln U_1} cos(2\pi U_2) \\ Z_1 & = \sqrt{-2\ln U_1} sin(2\pi U_2) \end{align}\]则\(Z_0,Z_1\)独立且服从标准正态分布。
George Edward Pelham Box,1919~2013,英国统计学家。伦敦学院大学博士,先后供职于普林斯顿大学和威斯康辛-麦迪逊大学。Ronald Aylmer Fisher的女婿。英国皇家学会会员,美国统计协会主席,数理统计学会(这是一个国际组织)主席。
Mervin Edgar Muller,俄亥俄州立大学教授。
https://mp.weixin.qq.com/s?__biz=MzI1MTIzMzI2MA==&mid=2650561098&idx=1&sn=675375265279cce7fdb1ecd94fd7a549
生成特定分布随机数的方法
numpy实战
从上面的描述可以看出,统计模拟一般包括两步:
1.生成均匀分布的随机数(Random generator)。例如:numpy.random.rand或tf.random.uniform。
2.通过采样(Draw samples)将分布变为特定分布。例如:numpy.random.multinomial或tf.random.categorical。
Mersenne Twister
LCG(线性同余发生器,Linear congruential generator)是最古老,也是最知名的伪随机序列生成器算法(Pseudorandom number generator, PRNG)。然而它也有一些缺点:
1.如果用于选择n维空间中的点,那么这些点至多会位于\((n! \cdot m)^{1/n}\)超平面(Marsaglia’s Theorem)。
2.当m为2的幂时,低阶比特周期较短。
PS:998244353是一个有名的质数n,因为n-1有个因数是\(2^{23}\),方便fft的分治算法。
因此,在Monte Carlo模拟或者加密算法领域,通常要使用更高质量的PRNG。
Mersenne Twister算法是1997年由Makoto Matsumoto(松本 眞)和Takuji Nishimura(西村 拓士)提出的算法。这种算法由于和梅森素数(Mersenne prime)有关,故名。
该算法最常见实现的随机数周期是梅森素数\(2^{19937}-1\),因此又被称为MT19937。原始的MT19937可以生成32位的随机数,它还有64位的版本:MT19937-64。
MT算法的实现也很多了,参见原作者的官网:
http://www.math.sci.hiroshima-u.ac.jp/~m-mat/MT/emt.html
周期长短管的是数列会不会重复,猜不猜得到是另一个维度的事。
MT每次取出一个状态字,做一道叫tempering的移位加异或再交出来,这道工序是可逆的。把一个输出倒推回去,得到的正好是一个状态字,连续拿到624个32位输出就等于拿到了全部状态。
密码学安全伪随机数生成器(CSPRNG)的要求只有一条,就算攻击者知道算法、看过之前全部输出,也算不出下一个数。
经典案例:
索尼给固件签名用的是ECDSA,这种签名每次都要现取一个随机数k,签名值是
\[s = k^{-1}(z + r \cdot d) \bmod n\]其中d是私钥,z是消息哈希,r由k算出。
索尼每次签名用的是同一个k,于是拿两份签名一联立,k和私钥d都能直接解出来。
\[k = \frac{z_1 - z_2}{s_1 - s_2} \bmod n, \qquad d = \frac{s_1 k - z_1}{r} \bmod n\]两个式子,主机的签名私钥就公开了。随机数质量再好,重复用一次也等于没有。
https://www.zhihu.com/answer/2092341310959240301
计算机中的伪随机是怎么实现的?
TestU01是一套用于随机数生成器(RNG/PRNG)统计质量评估的开源C库,由蒙特利尔大学的Pierre L’Ecuyer和Richard Simard等人开发维护;
George Marsaglia(1924–2011),美国数学家、计算机科学家,随机数与伪随机生成器(PRNG)领域的奠基人之一。2003年发表了xorshift算法。
Philox
除了MT算法之外,Philox算法也是比较常用的,且后者更适合并行,速度也更快。
Philox原作者官网:
http://www.thesalmons.org/john/random123/
Philox算法的实现一般以philox_4x32_10的形式命名,它表明算法一次能生成4个32位的无符号数,10表示运算迭代的次数。
官方的代码由于要考虑各种兼容性,写的复杂无比,这里有一个精简版:
https://github.com/antkillerfarm/antkillerfarm_crazy/blob/master/Tool/Gcc/random/philox.c
还有一个进阶版,增加了多线程并行生成、均匀分布变换、正态分布变换的功能:
https://github.com/antkillerfarm/antkillerfarm_crazy/blob/master/Tool/Gcc/random/philox_1.c
这个算法能够并行的要害在于,它有两个寄存器:种子寄存器和状态寄存器。这两个中任意一个不同,都会生成不同的随机数序列。
类似的,在tf中有两组随机数生成器:tf.random.stateless_xxx和tf.random.xxx。
所谓的stateless是指,只要种子确定,每次运行都会生成相同的随机数序列。
CUDA除了Philox算法生成器之外,还有XORWOW生成器和MRG32k3a生成器。
https://zhuanlan.zhihu.com/p/694166229
蒙特卡洛应用
https://bashtage.github.io/randomgen/index.html
这是一个RNG(Random Number Generation)项目,集成了多种算法。
参考:
https://blog.csdn.net/wuha391/article/details/78486021
随机算法mt19937
https://blog.csdn.net/caimouse/article/details/55668071
mt19937是什么鬼?
http://michaelbrundage.com/note/2005/01/05/random-number-generation/
这是一篇RNG方面的综述。
http://www.azillionmonkeys.com/qed/random.html
这篇blog讲述了将随机整数变为浮点数,需要注意的问题。
统计力学与组合优化
MCMC和Gibbs Sampling最早都是统计力学的概念,后来才被用于机器学习领域。现将统计力学与组合优化的对应关系罗列如下:
| 统计力学 | 组合优化 |
|---|---|
| 样本 | 问题实例 |
| 状态(构形) | 构形 |
| 能量 | 代价函数 |
| 温度 | 控制参数 |
| 基态能量 | 最小代价 |
| 基态构形 | 最小构形 |
频率统计学派 vs. 贝叶斯学派
对数学史感兴趣的朋友,可以看看陈希孺院士的《数理统计学简史》一书。rickjin文章的内容有相当部分取自该书。
陈希孺,1934~2005,数理统计学家。1956年毕业于武汉大学数学系,1997年当选为中国科学院院士。
该书中关于频率统计学派和贝叶斯学派的争议,引起了我的注意。
频率统计学派是所谓的正统派,由于其简单且便于理解的特点,多数入门级的数理统计学教程,一般都是按照该学派的思路写的。
而贝叶斯学派可谓另辟蹊径,它和频率统计学派的差异,参见《机器学习(九)》。由于该派系的思想比较新颖,我一度以为它和频率统计学派的关系,就犹如相对论之于经典力学。
您的打赏,是对我的鼓励