DL acceleration » 并行 & 框架 & 优化(十一)——Batching
2026-03-02 :: 3362 WordsBatching
continuous batching
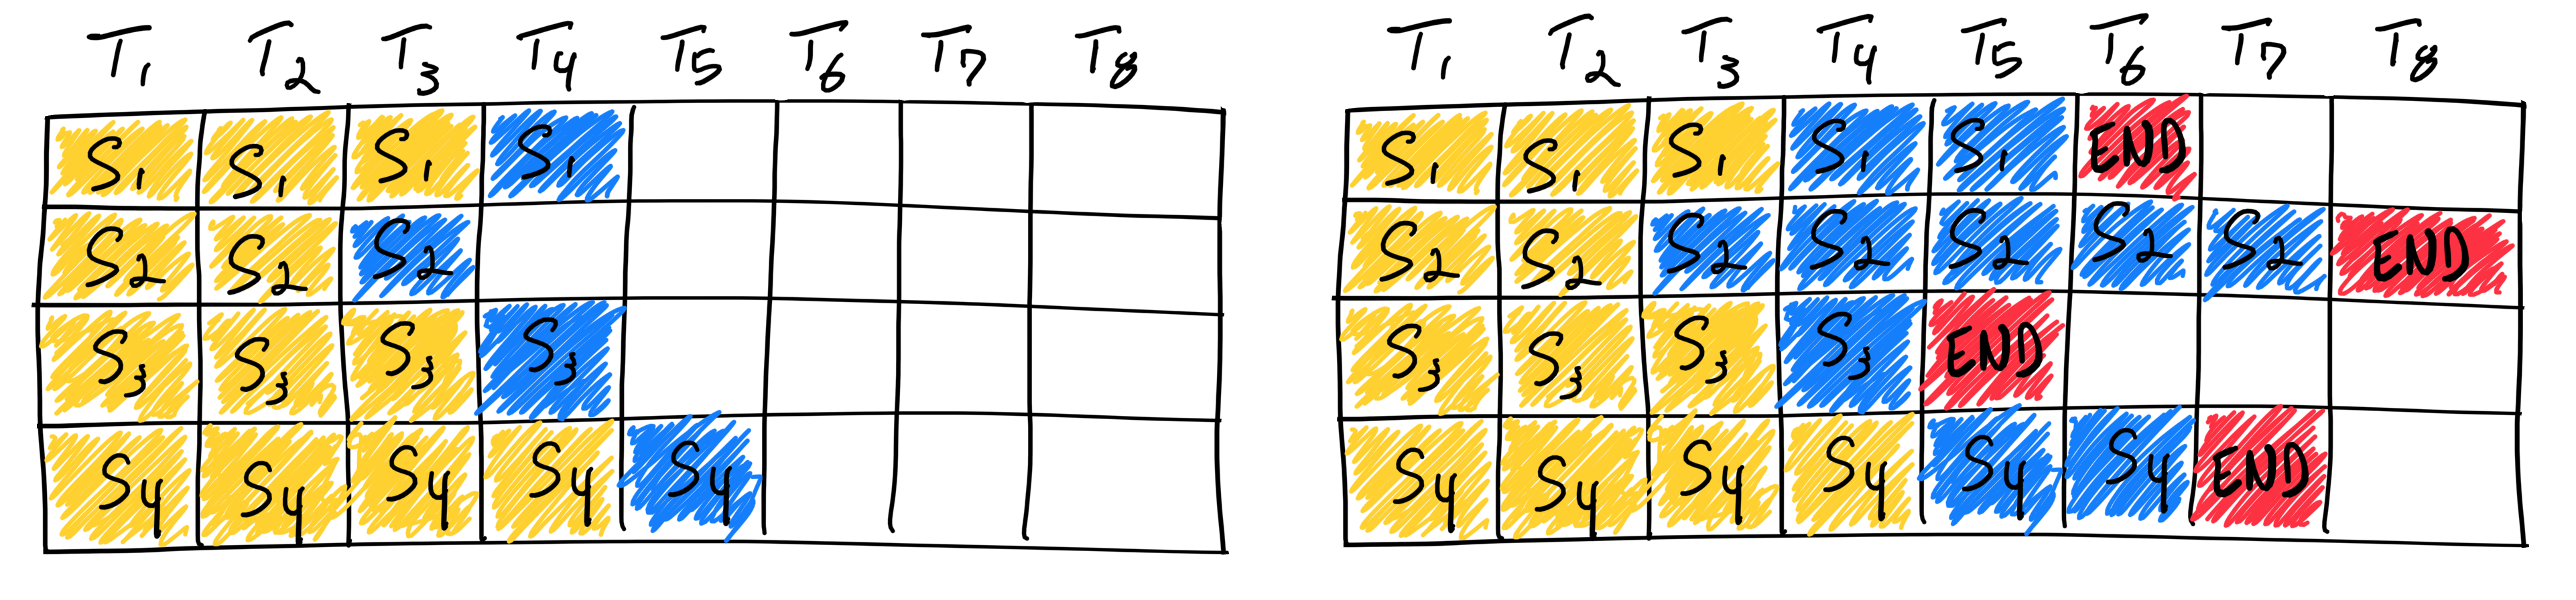
上图是一个通常的多batch的LLM的Inference过程。其中黄色表示用户的prompt,蓝色表示LLM生成的文本,红色表示结束符号。

这是改进后的continuous batching的示意图。
https://www.anyscale.com/blog/continuous-batching-llm-inference
How continuous batching enables 23x throughput in LLM inference while reducing p50 latency
Selective Batching
Selective Batching的核心原理在于:仅对适合批处理的操作执行批处理,不适合批处理的操作则单独处理。
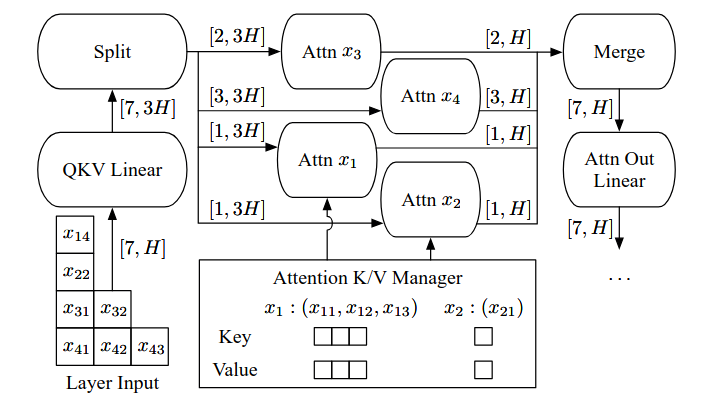
对于preproj、postproj、FFN1和FFN2这类线性变换或归一化操作,它们的计算与序列长度无关,只是在hidden_size维度上做线性转换,并且都需要从显存读取权重。因此,可以将batch内所有token拉平成一个二维张量。
对于Attention操作,由于每个请求的mask、KV cache和token位置可能不同,导致其张量形状不一致,无法直接合并处理。Selective Batching会在进入Attention之前将batch拆分,逐个请求单独计算Attention分数,完成后再将结果合并回统一的张量。
Chunked Prefill
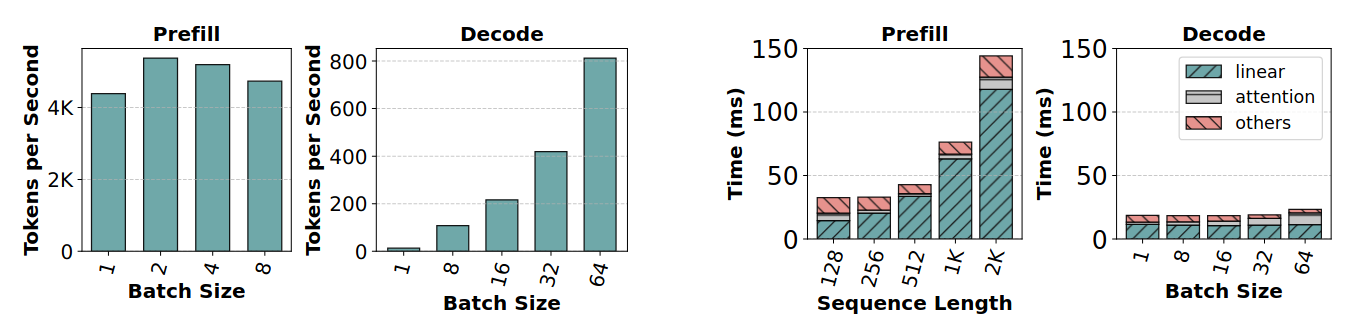
在prefill阶段,即使batch size为1,所有操作的算术强度依然很高。而在decode阶段,这些操作的算术强度下降了两个数量级以上,只有在batch size达到256这种极大值时,decode阶段才开始变得计算密集。
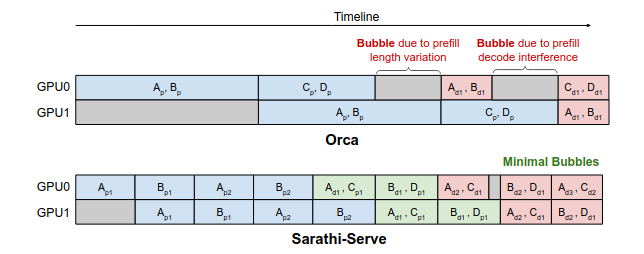
Orca方案尝试在Batch中混合Prefill和Decode请求。但是由于请求具有一定的随机性,Prefill和Decode的计算量不一定平衡,从而产生了pipeline bubbles。
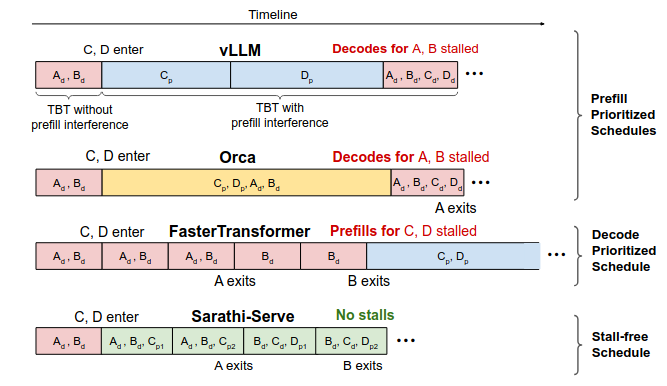
Sarathi-Serve提出了一种兼顾吞吐量与延迟的调度机制,其中包括两个核心设计思想:chunked-prefills(分块预填充)和stall-free scheduling(无阻塞调度)。
- chunked-prefills(分块预填充):将一个prefill请求拆分为计算量基本相等的多个块(chunk),并在多轮调度迭代中逐步完成整个prompt的prefill过程(每次处理一部分 token)。
- stall-free scheduling(无阻塞调度)则允许新请求在不阻塞decode的前提下,动态加入正在运行的batch,通过将所有decode请求与新请求的一个或多个prefill chunk合并,构造出满足预设大小(chunk size)的混合批次。
https://zhuanlan.zhihu.com/p/1928005367754884226
Chunked-Prefills分块预填充机制详解
https://zhuanlan.zhihu.com/p/718715866
基于chunked prefill理解prefill和decode的计算特性
Append
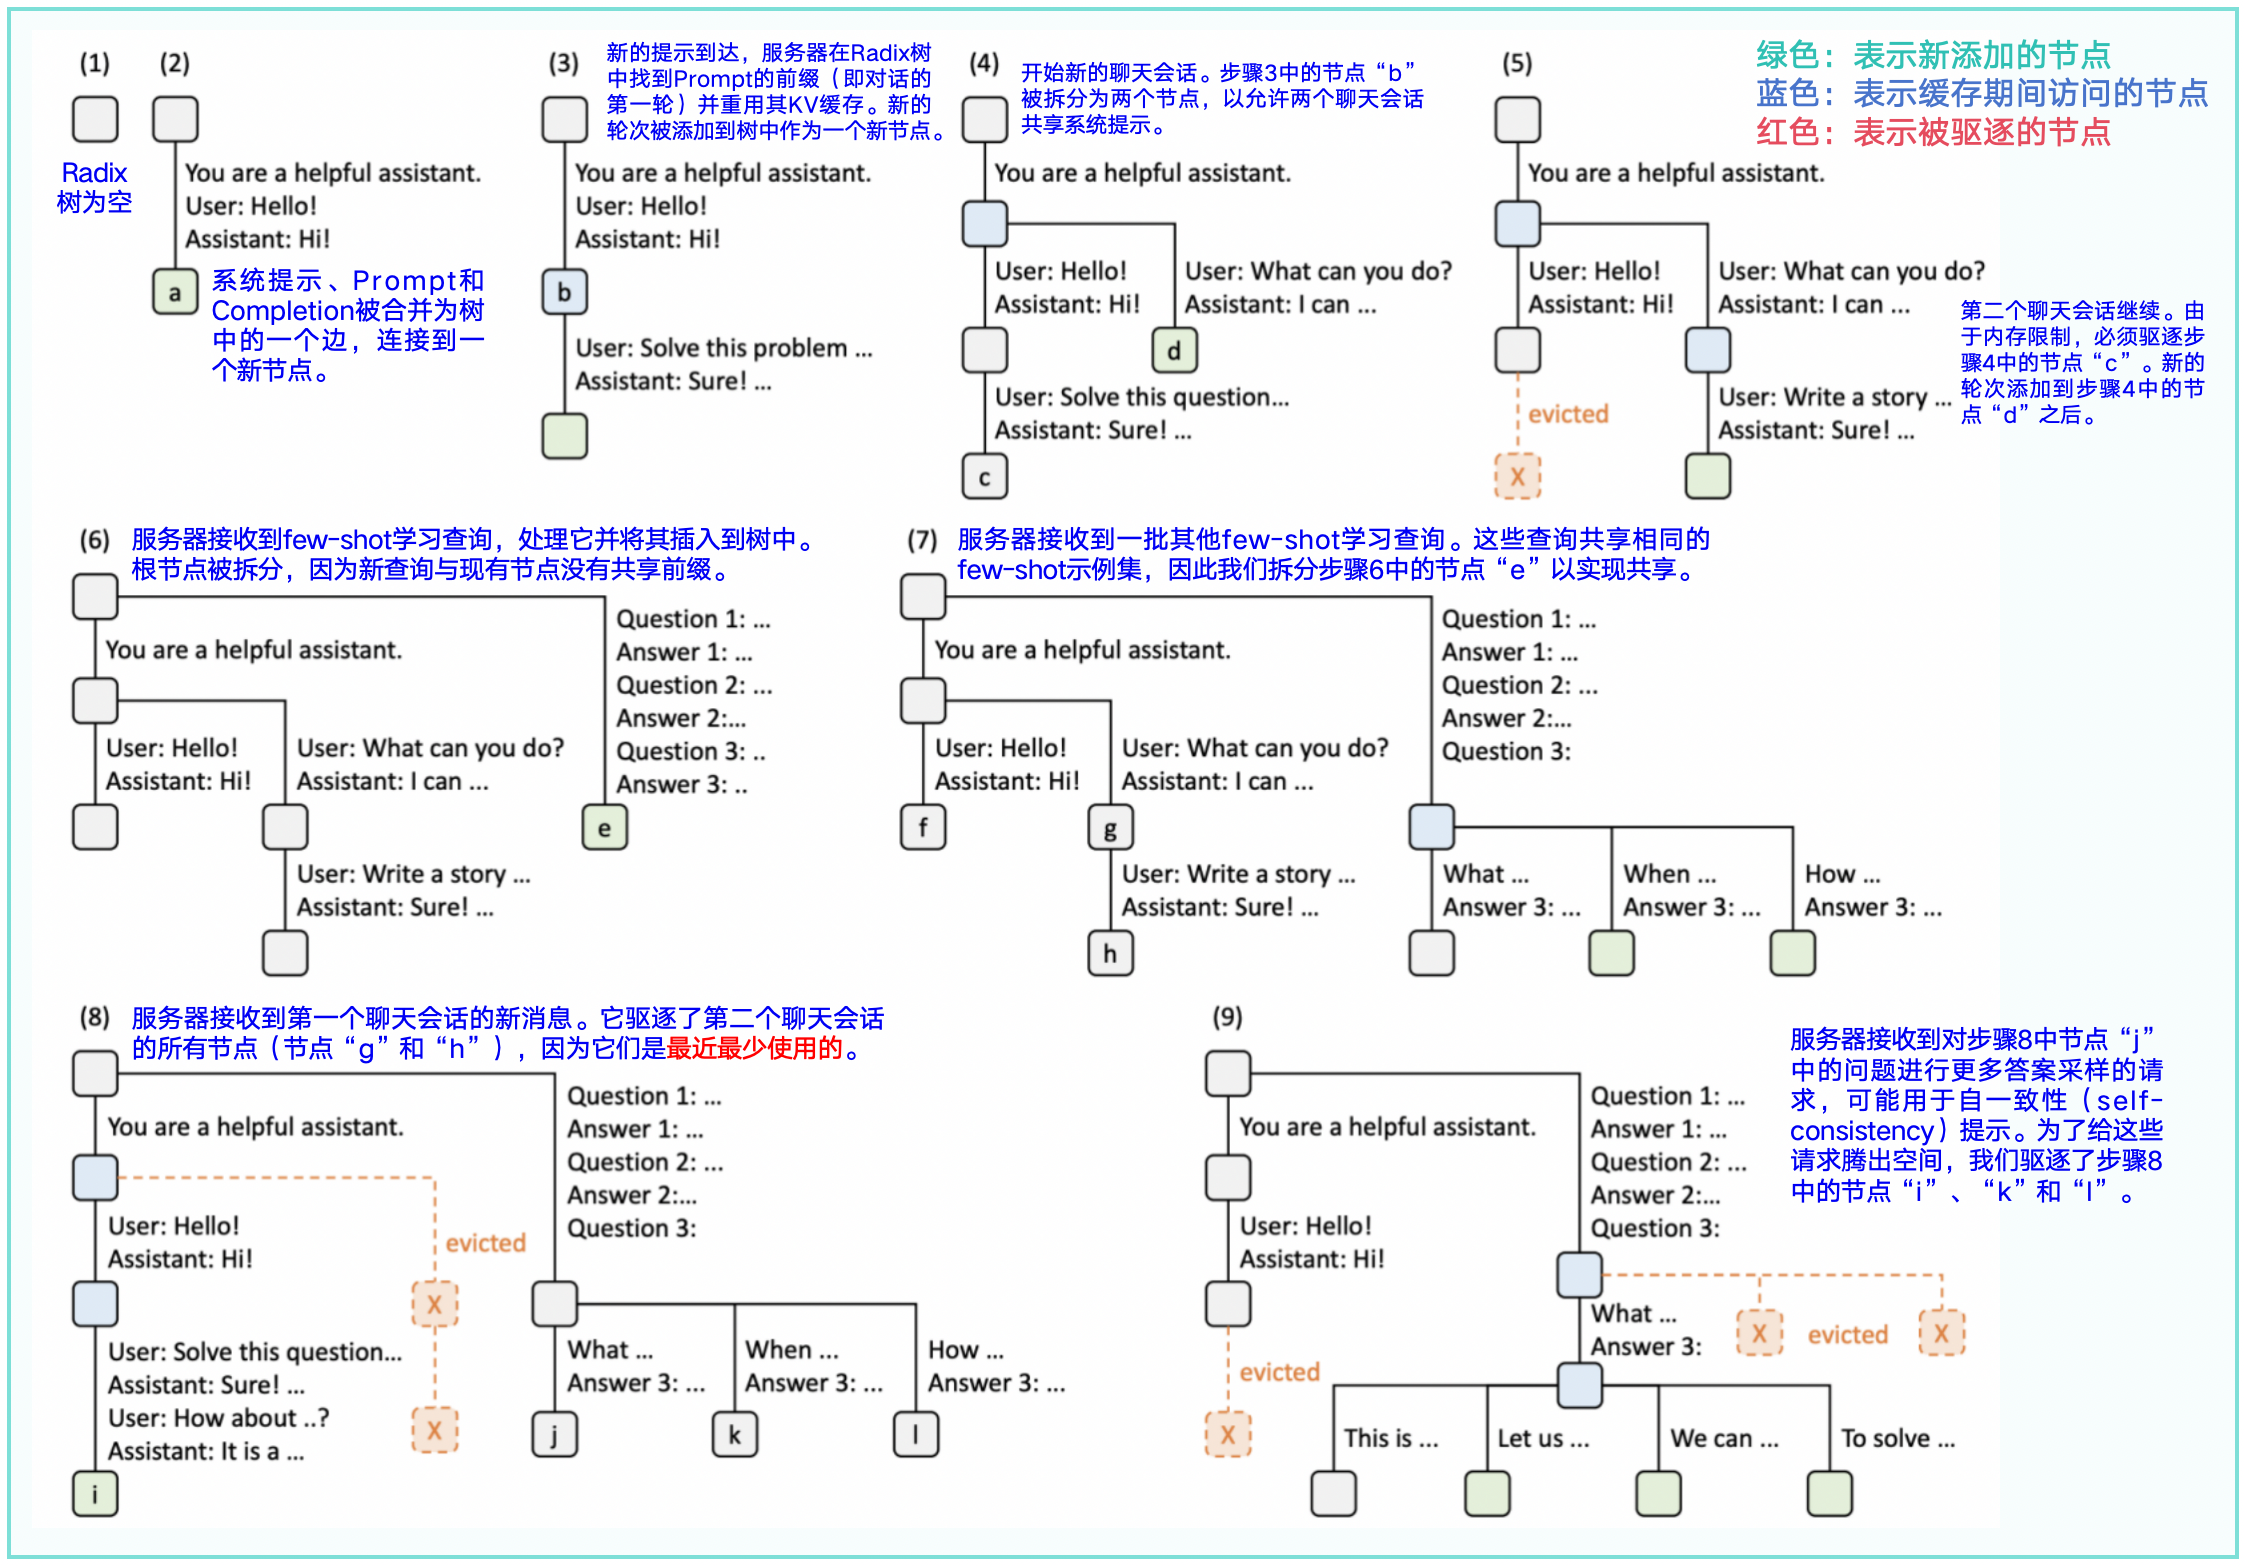
多轮对话情况下,用户第2轮再输入一段文字,系统对这段输入文字做一次新的prefill,然后用把新生成的KV拼接到上一轮cache后面,这个操作被称为Append操作。
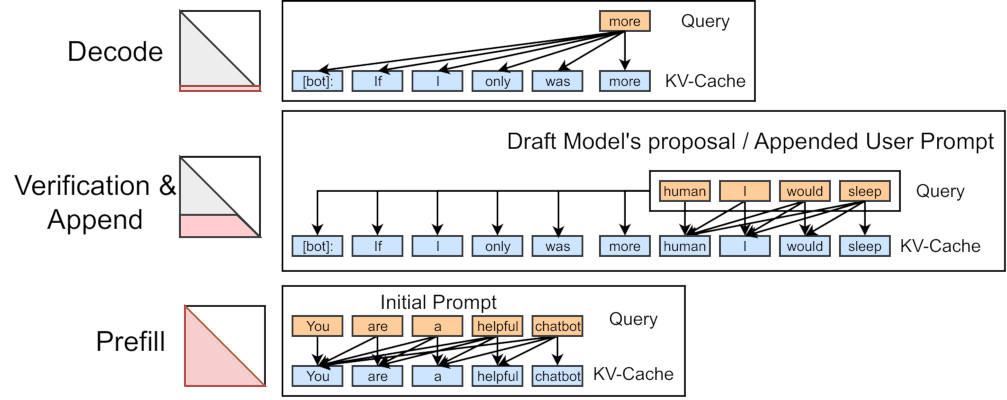
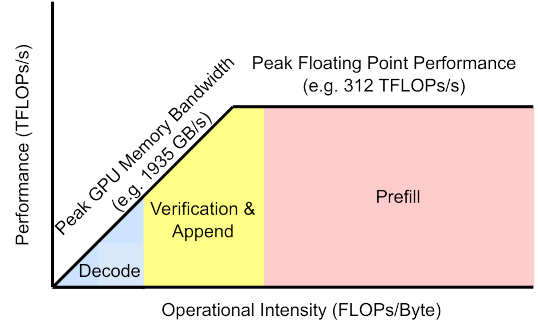
Append操作一般采用Prefix Caching技术进行加速。
RadixAttention使用radix tree,而不是prefix tree。Radix Tree最大的特点就是,它的node,不仅可以是一个单独的元素,也可以是一个变长的序列。具体体现在,在必要的时候,一个已经在Tree中的大node可以动态地分裂成小node,以满足动态shared prefix的需求。
https://zhuanlan.zhihu.com/p/693556044
原理&图解vLLM Automatic Prefix Cache(RadixAttention)首Token时延优化
https://zhuanlan.zhihu.com/p/1890132185966682238
FlashAttentionV1/V2+PageAttentionV1/V2+RadixAttention算法总结
工具
FairScale是由Facebook Research开发的PyTorch扩展库。FSDP就是首发于这个库。
https://zhuanlan.zhihu.com/p/412118353
Kokkos:一个异构并行计算通用平台
LLGuidance是Guidance-AI开源的一个超高速“约束解码”引擎,用Rust写成,专门帮大模型在生成时强制遵守你给出的结构规范(JSON Schema、正则、EBNF/Lark 文法等),从而得到100%合规的结构化输出。类似的引擎还有XGrammar。
Ray是一个分布式计算框架,专为大规模并行任务和强化学习应用设计。它由加州大学伯克利分校的研究团队开发,旨在简化构建高性能、可扩展的分布式应用程序的过程。
https://mp.weixin.qq.com/s/Na2SJkfC9LzgfbTfSCclOw
如何基于Ray使用15行代码实现参数服务器
https://mp.weixin.qq.com/s/IqjKdAlGYREqCR9XQB5N1A
伯克利AI分布式框架Ray,兼容TensorFlow、PyTorch与MXNet
https://mp.weixin.qq.com/s/jOVUPhrCBI9W9vPvD9eKYg
UC Berkeley提出新型分布式框架Ray:实时动态学习的开端
DeepWiki由Cognition AI推出,输入任何GitHub仓库地址,DeepWiki自动抽取出项目架构、模块关系、API 说明、依赖图等内容,生成可浏览、可对话的在线文档。
数据流并行
数据流并行是Pipeline并行的高阶版本。广义的数据流希望通过图编译找到全局最优策略,本质上是一种把编译器当万金油的惰性做法,深度学习框架在系统调度这种比较粗放的尺度,围绕数据流做了这么多年的自动并行化,最后业界主流实际上的并行策略还是预设的这些Pipeline、Tensor并行的组合,而不是编译器搜出来的自动化的并行策略。
并行 & 框架 & 优化参考资源
https://mp.weixin.qq.com/s/rEHhf32L09KXGJ9bbB2LEA
TensorFlow在美团外卖推荐场景的GPU训练优化实践
https://zhuanlan.zhihu.com/p/522759214
手把手推导分布式矩阵乘的最优并行策略
https://mp.weixin.qq.com/s/_o7fzCOeuZE6qFc5gHb26g
美团视觉GPU推理服务部署架构优化实践
https://mp.weixin.qq.com/s/X7XG51yohLnEZ_Jg6XK9oQ
Caffe作者贾扬清教你怎样打造更加优秀的深度学习架构
https://zhuanlan.zhihu.com/p/529388795
训练千亿参数大模型,离不开四种GPU并行策略
https://mp.weixin.qq.com/s/_mrYI7McMBUx0lEh4rNiYQ
百度开源移动端深度学习框架MDL,手机部署CNN支持iOS GPU
https://mp.weixin.qq.com/s/ZCNSq5FC2REoVTKAK2mJQg
分布式深度学习原理、算法详细介绍
https://mp.weixin.qq.com/s/Ewiil56vMkzhO2xDWgo-Wg
苹果发布Turi Create机器学习框架,5行代码开发图像识别
您的打赏,是对我的鼓励