Attention » Large Language Model(六)——LLM Architecture, VLM
2026-06-30 :: 4596 WordsLLM Architecture(续)
Gemma 4
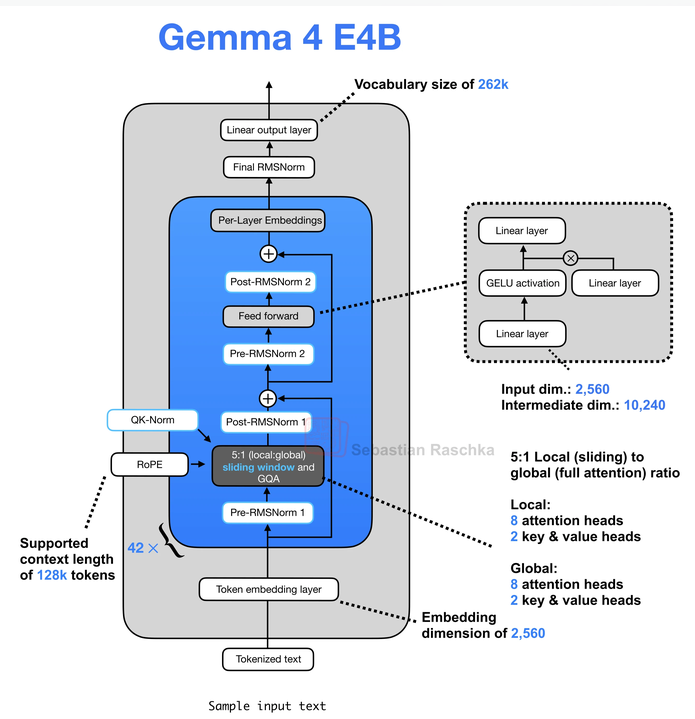
Per-Layer Embedding:
- 常规LLM(Gemma2、LLaMA 等)只有输入头部唯一一张全局嵌入表。
- PLE把超大词表向量存为静态只读查找表。推理阶段根据token ID,直接取出表格里预先存好的浮点向量。
- PLE不是在模型最开头只查一次,而是每一个 Transformer 解码器层,都附带一张小型词嵌入查表。
- 超大PLE嵌入表可以放在手机闪存(UFS/eMMC),不需要全部加载进高速NPU/RAM,用到哪个token就临时读取对应向量,宝贵的高速内存只放需要浮点计算的主干参数。
- MoE实现计算稀疏,PLE实现存储稀疏。
从Gemma4技术报告披露的消融数据可以看出,DeepMind做过稠密+PLE、MoE+传统嵌入、稠密无PLE三组对照,唯独没有公开MoE+PLE的权重,社区推测多半是收益不足以覆盖部署成本。
Qwen 3.5
Kimi K2
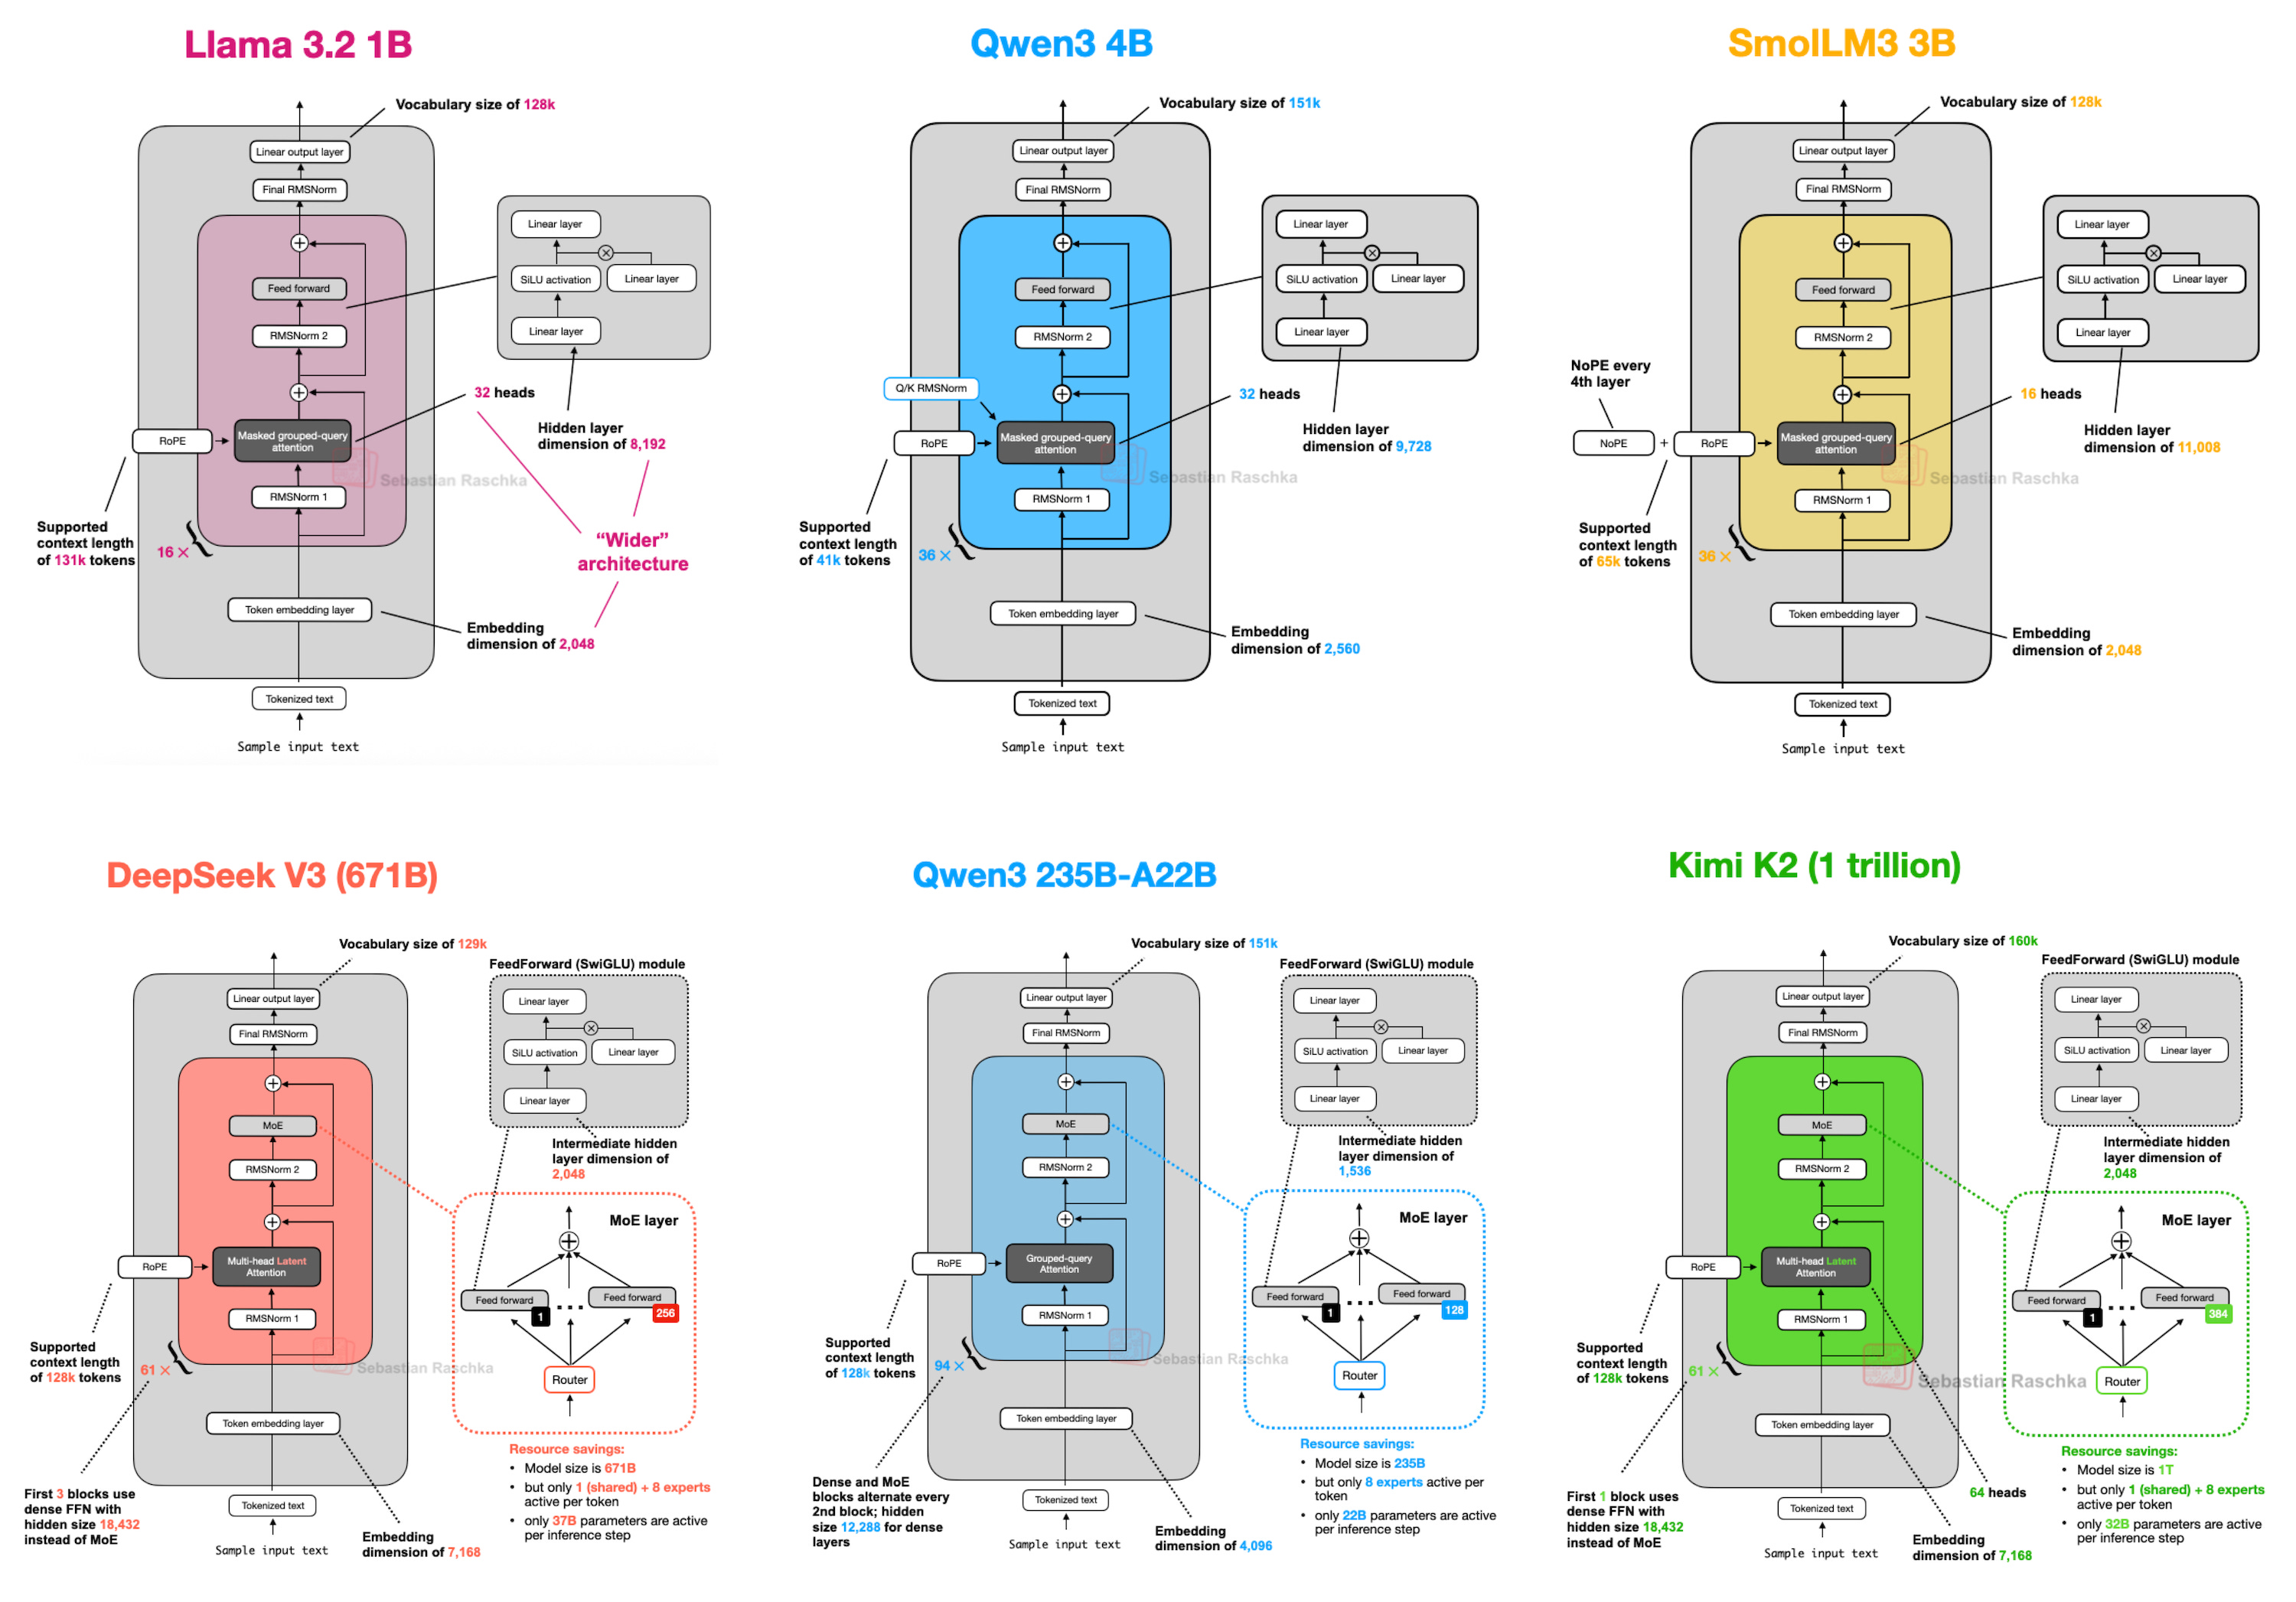
官方技术报告:
https://moonshotai.github.io/Kimi-K2/
参考:
https://www.zhihu.com/question/1927140506573435010
Kimi发布首个万亿参数开源模型K2模型,哪些信息值得关注?
Kimi K3
2026.7 Kimi K3 2.8T参数。E=896,K=16。
https://www.kimi.com/blog/kimi-k3
K3技术报告
Qwen3.8-Flash-Next
2026.8 Qwen3.8-Flash-Next
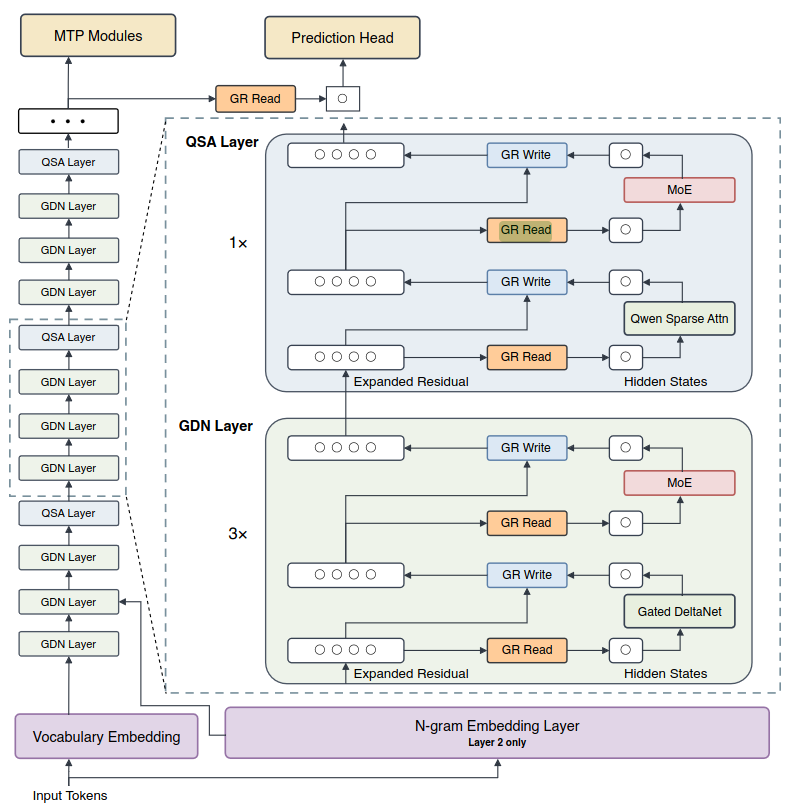
Gated Residual(GR),参考Deepseek的mHC使用了多流残差分支,只是Qwen3不使用双随机矩阵约束而是使用门控矩阵约束。
Expanded Residual (扩展残差流):将原本单一的残差流扩展为 4条并行分支。这为模型提供了多条信息通路,类似于一个更宽的高速公路,让信息在不同层之间流动时拥有更多选择。
GR Read:在每个模块(如Attention或MoE)处理前,使用一个动态的、逐元素的(element-wise)读门控(Read Gate),从4条残差分支中有选择地读取信息。这相当于一个智能的信息过滤器,决定当前模块应该重点利用哪些历史信息。
GR Write:在模块处理完成后,使用一个每分支的标量写门控(Write Gate),控制模块的输出以多大比例写回到各条残差分支中。
和Gated Residual(GR)类似的,还有Tencent Hy4-preview提出的iHC。
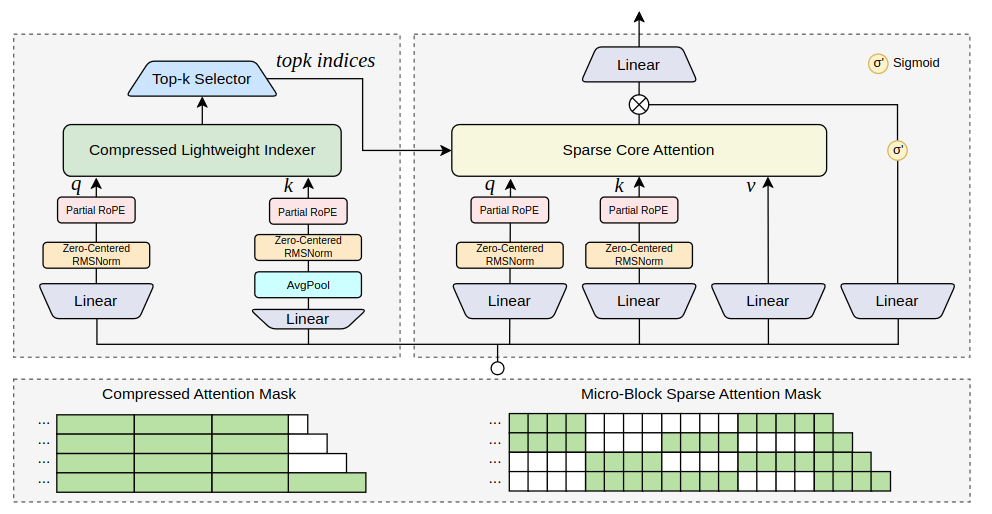
QSA (Qwen Sparse Attention)不直接处理单个Token,而是将序列划分为更粗粒度的微块(Micro-block)。它使用一个轻量级的Indexer来评估这些块的重要性,并只选择最重要的块进行传统的注意力计算,未选中的块则被稀疏处理。
N-gram嵌入为参数扩展提供了一个独特的维度,相比混合专家(MoE)方法,它所需的计算更少,且更易于卸载(offloading)。缺点就是训练时要做一次All-to-All通信,增加了训练成本,其实更适合小模型提升极限的推理时性能。
Qwen3.8-Flash-Next的N-gram Embedding部分,参考了DeepSeek的Engram,如下图所示:
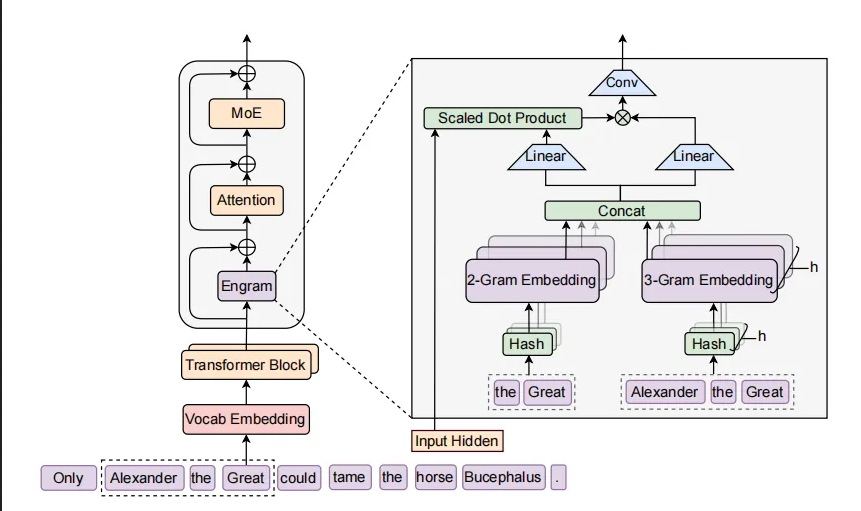
Qwen的测试结果显示,多层注入没有稳定优势,一个N-gram层已经足够。选择Layer 2还能让系统利用第一层的计算时间,从Host Memory提前读取接下来需要的向量。
原本176B的模型现在变成了125B(内存)+51B(SSD)。
DeepSeek V4.1 Flash
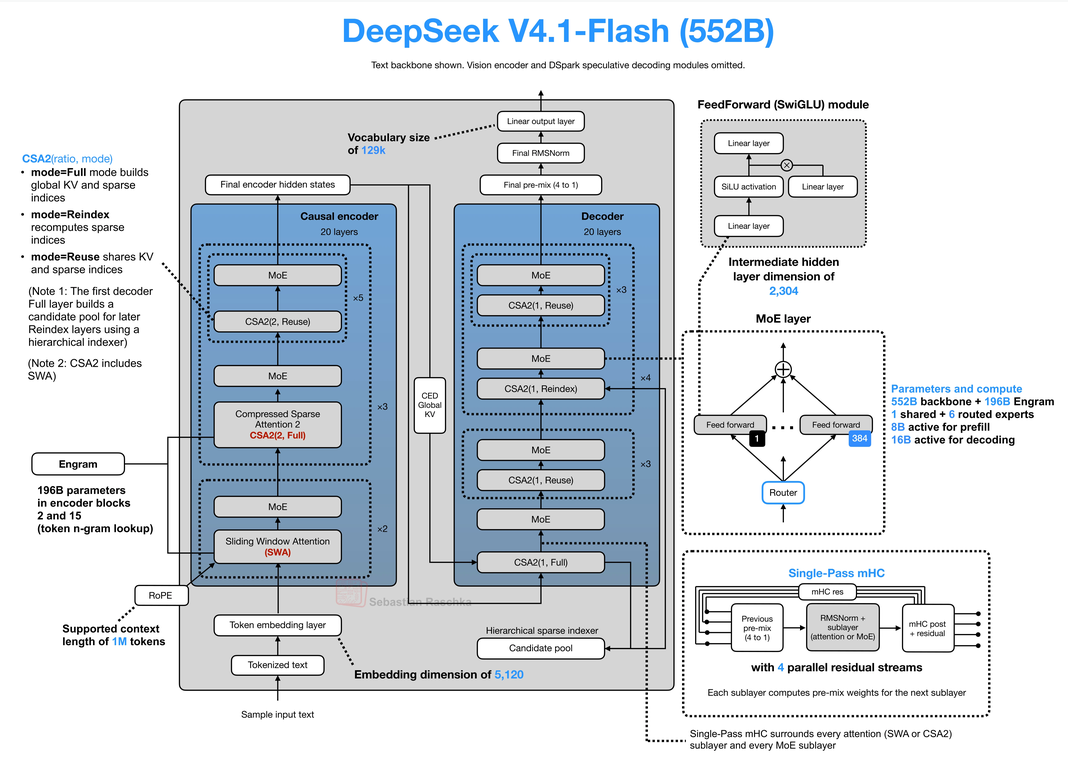
相比DeepSeek V4,DeepSeek V4.1 Flash主要包括了以下创新点:
- YOCO
- Engram
- CSA2
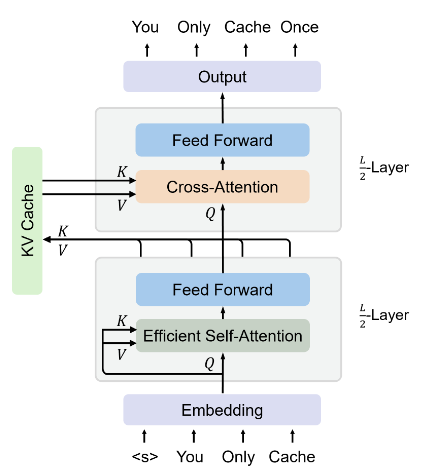
YOCO(You Only Cache Once)采用L块堆叠,其中前L/2层为Self-Decoder,其余模块为Cross-Decoder。
自解码器与交叉解码器的区别在于它们各自的注意力块不同,自解码器使用高效的自注意机制(例如Slide Window Attn)。而交叉解码器使用全局交叉注意力来关注自解码器输出产生的共享KV Cache。
这里的共享KV Cache是指,Self-Decoder的L/2层,只有最后一层有KV Cache,而这个KV Cache会给Cross-Decoder的所有L/2层使用。因此KV Cache的存储复杂度是\(O((N+L)D)\),其中N、L、D分别为序列长度、层数和隐藏维数。(Decode阶段的input还是会在Cross-Decoder的每一层生成自己的KV Cache)
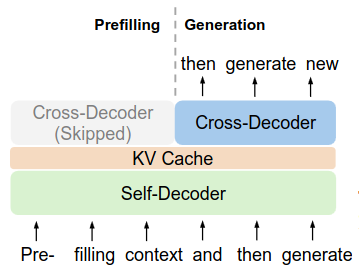
Prefill阶段,除了最后一个input token之外,只走Self-Decoder,用以生成KV Cache,Decode阶段Self-Decoder和Cross-Decoder都要走。
这里有个技巧,普通的Transformer模型,最后的lm head运算,实际上也只有最后一个input token生成第一个output token是有意义的。
https://zhuanlan.zhihu.com/p/697295435
You Only Cache Once:YOCO基于Decoder-Decoder的一个新的大语言模型架构
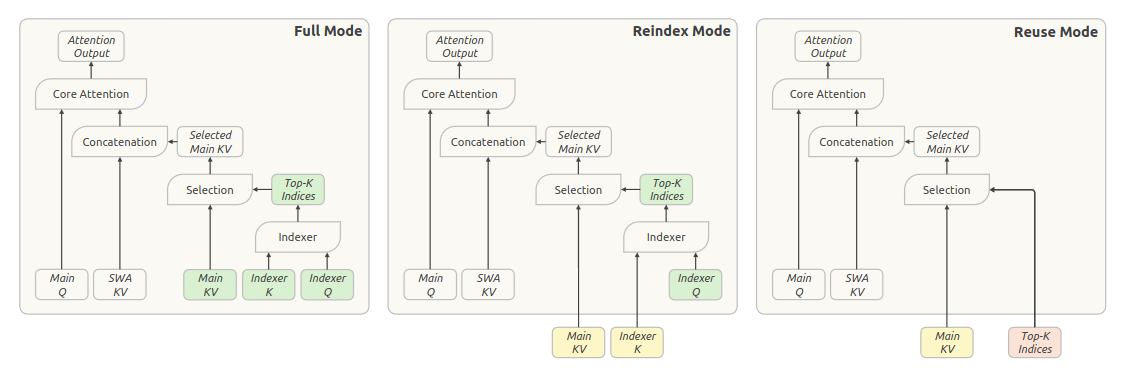
CSA2,把压缩从CSA的Seq维度再加到Layer维度。
CSA2分三种模式:
- Full:自己算main KV、indexer K,跑完整top-k索引。
- Reindex:复用前层main KV / indexer K,但用自己的query重新打分选top-k(缓存共享、选择不共享)。
- Reuse:main KV和top-k索引都复用前层,本层只跑注意力,不重算索引。
Clamp SwiGLU:从OpenAI、Kimi到DS都这么干,可能之前训崩就是这问题?
https://www.zhihu.com/question/2081380378493961583
如何评价正式发布的DeepSeek V4.1 Flash?
VLM
https://zhuanlan.zhihu.com/p/702811733
Vision-Language Models (VLMs)多模态大模型一年多的进展与思考-2406
Qwen 2.5-VL
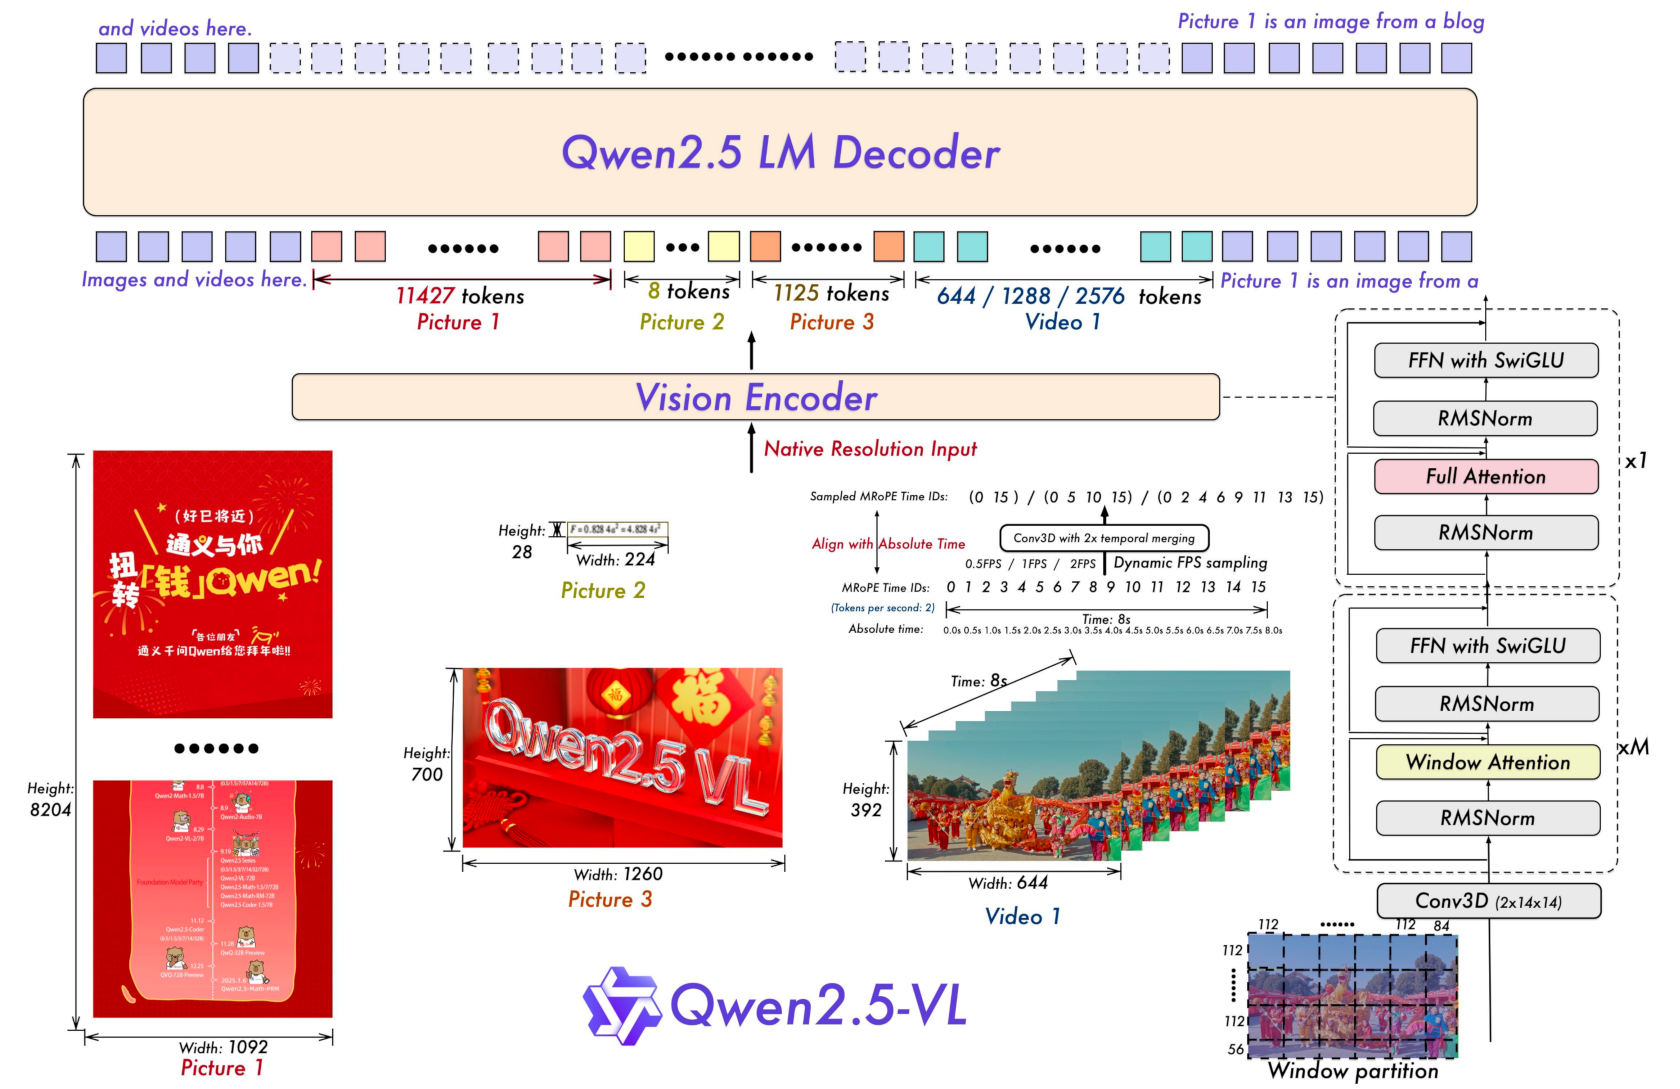
该模型将视觉Token包裹在<|vision_start|>、<|vision_end|>标签内,嵌入文本Token中,实现了对于任意尺寸、数量的图片/视频的支持。
此外该模型还引入了多模态旋转位置嵌入M-RoPE(Multimodal RoPE)和Partial-RoPE,以更好地处理视频中的时间信息。
https://blog.csdn.net/v_JULY_v/article/details/145560246
一文通透Qwen2.5 VL:从Qwen-VL、Qwen2-VL到Qwen2.5-VL
Qwen 3-VL
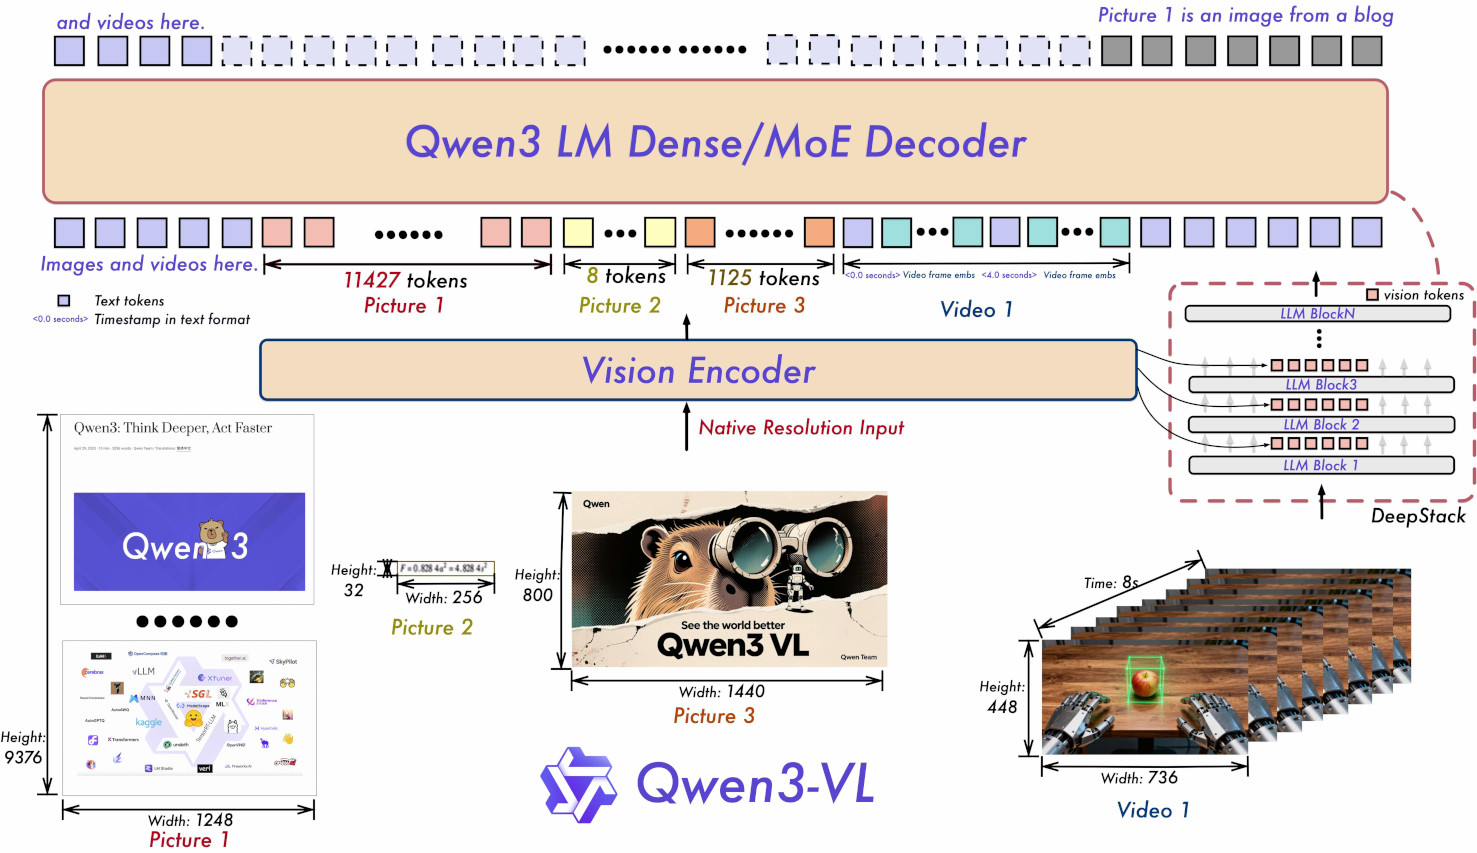
https://blog.csdn.net/v_JULY_v/article/details/160890094
一文通透Qwen3-VL——在交错式MRoPE、DeepStack、文本时间戳对齐机制的基础上,先预训练,再后训练(即分别SFT、蒸馏、RL)
DeepSeek-OCR
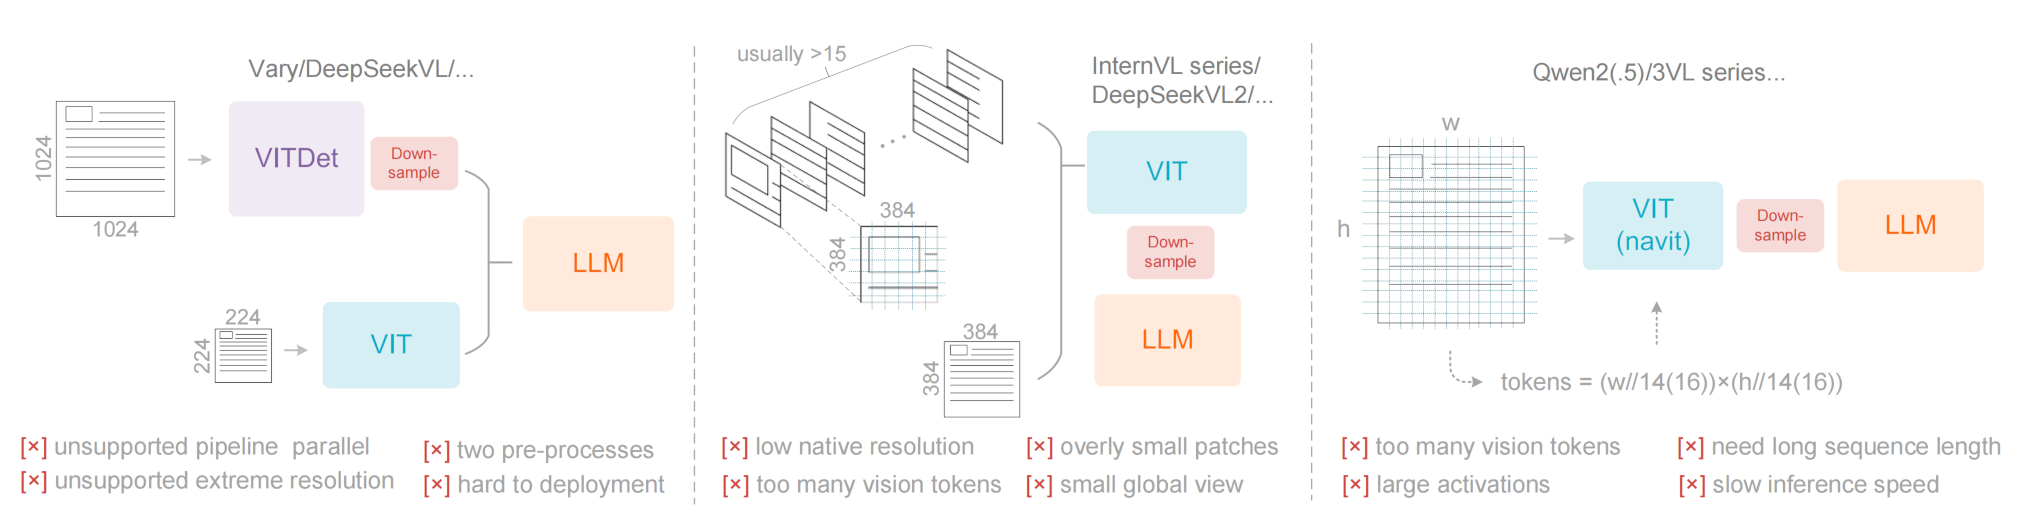
当前开源VLM主要采用三类视觉编码器,如上图所示。
第一类是由Vary代表的双塔架构,利用并行的SAM编码器,通过增加视觉词汇参数来实现高分辨率图像处理。该方法虽然可以控制参数量和激活内存,但存在显著缺点:需要对图像进行两次预处理,增加了部署复杂度,并使训练过程中编码器流水线并行性变得困难。
第二类是以InternVL2.0为代表的分块(tile-based)方法,通过将图像分割为小块并并行处理,从而在高分辨率设置下降低激活内存消耗。虽然这种方法能够支持极高分辨率,但由于原生编码器分辨率通常较低(低于512×512),导致大尺寸图像被过度切分,产生大量视觉Token,存在明显局限性。
第三类是以Qwen2-VL为代表的自适应分辨率编码,采用NaViT框架,通过基于patch的切分直接处理完整图像,无需tile并行。虽然该编码器能灵活适应多种分辨率,但在处理大尺寸图像时,会消耗大量激活内存,易导致GPU显存溢出,并且训练时序列打包需要极长的序列长度。过长的视觉Token序列会显著降低推理的预填充和生成速度
如何评价DeepSeek-OCR-2模型?
https://blog.csdn.net/v_JULY_v/article/details/154699042
DeepSeek-OCR——上下文视觉压缩:同等长度下,通过更少的视觉token解决长上下文处理难题
VLA
VLM(Vision-Language Model)仅做跨模态“理解”或“生成”:输入图像/视频+文本,输出文本(描述、问答、检索分数等)。
VLN(Vision-Language Navigation)在 VLM 之上加“导航”任务:输入一句自然语言指令与当前视觉帧,输出离散或连续动作,直到到达语言描述的目标点。
VLA(Vision-Language Action)进一步把“导航”泛化为“任意物理动作”:输出低层连续控制信号(关节力矩、车轮转角、油门刹车等),完成抓取、驾驶、开关抽屉等操作。

上图是X-VLA的网络结构图。
https://blog.csdn.net/v_JULY_v/article/details/158262322
X-VLA——基于Soft Prompt的Transformer编码器练就可扩展的跨本体VLA:VLM做多模态感知,DiT-style做动作生成
LLaVA
LLaVA(Large Language and Vision Assistant)是一个大型的多模态模型,它的能力包括:
- 理解视频/图片的内容。
- 根据用户指令生成视频/图片。
https://zhuanlan.zhihu.com/p/692398098
LLaVA系列多模态大模型总结
LLM应用
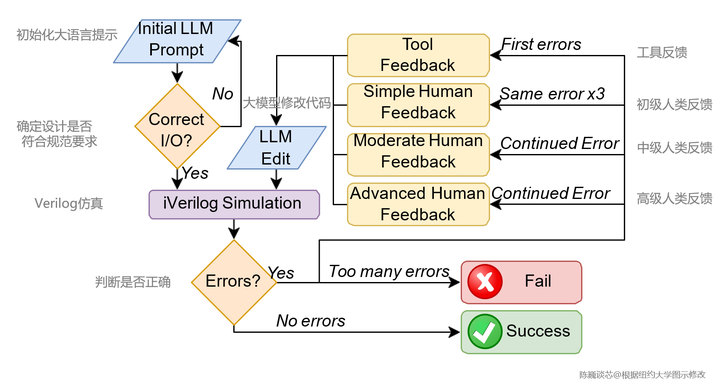
大语言模型参与的芯片前端设计迭代流程
Vibe Coding是一种2025年才出现、以AI为核心的全新软件开发方式:开发者不再逐行手写代码,而是用自然语言把“想要什么”告诉大模型,由AI生成、修改并反复迭代,直到“感觉对了”就上线——整个过程更像“对话+氛围感知”,而不是传统意义上的编码。
https://www.zhihu.com/question/1944542162130833916
什么是Vibe Coding?
您的打赏,是对我的鼓励