Generative Model » AIGC(三)——Flow-based Model, AIGC参考资源
2026-06-08 :: 4699 WordsAutoregressive Model
VAR(续)
VAR的一作田柯宇,后来干了一票大事:
https://www.zhihu.com/question/1296528119
字节跳动大模型训练被实习生恶意注入破坏代码,涉事者已被辞退,攻击带来的影响有多大?
Flow-based Model
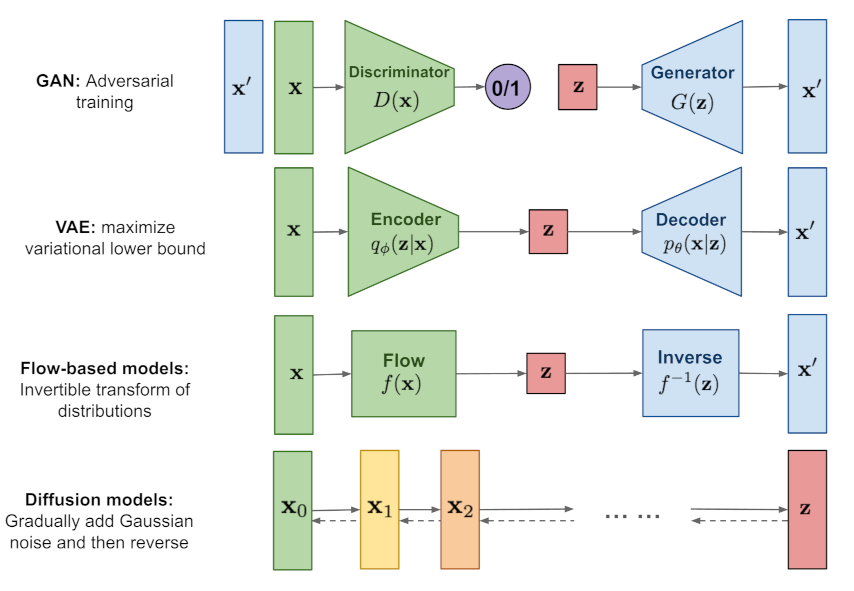
Flow-based Model是GAN和VAE之外的另一大类生成模型方法。
从表面来看,Flow-based Model和VAE非常类似,无非把Encoder和Decoder换成了Flow和它的Inverse,但是实际上两者不仅数学原理不同,具体的训练方法也有极大差异。上图说是照骗也不为过。
以下内容主要参考了李宏毅老师的课件:
http://speech.ee.ntu.edu.tw/~tlkagk/courses/ML_2019/Lecture/FLOW%20(v7).pdf
还有以下笔记:
http://www.seeprettyface.com/pdf/Note_Flow.pdf
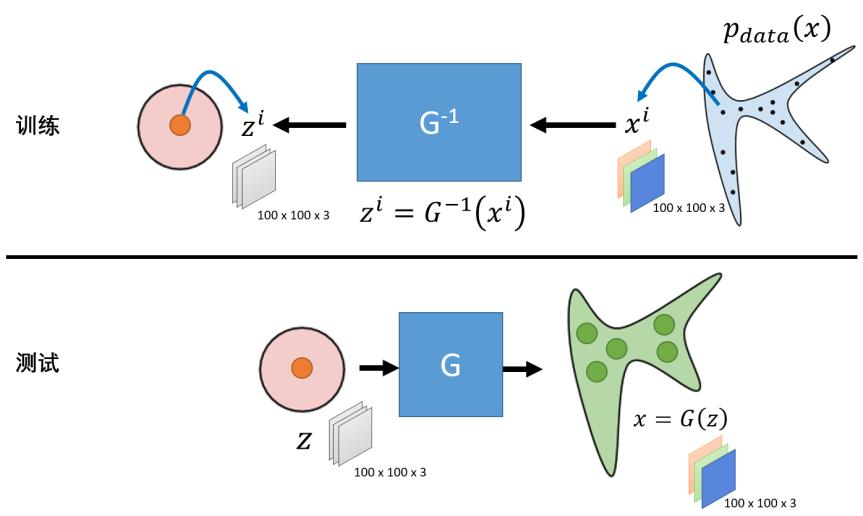
Flow-based Model的训练过程是用图片x通过网络\(f(x)\)生成随机数z。由于这个经过巧妙构造的\(f(x)\)具有可直接得到的可逆函数\(f^{-1}(z)\),所以在推理阶段,无需任何额外处理,即可直接由\(f^{-1}(z)\),从随机数z得到图片x。
随机数z可以是任意分布,但通常为了理论推导的简单,而使用正态分布,即所谓的Normalizing Flow。
Flow-based Model的理论不算复杂,难点主要在于如何构造可逆的函数G。目前已经有了一些成熟的构造方法,但相对于网络结构的千变万化,构造方法的种类就少的太多了。主流的大概也就是NICE、RealNVP和GLOW。
最初的NICE实现了从A分布到高斯分布的可逆求解;后来RealNVP实现了从A分布到条件非高斯分布的可逆求解;而最新的GLOW,实现了从A分布到B分布的可逆求解,其中B分布可以是与A分布同样复杂的分布,这意味着给定两堆图片,GLOW能够实现这两堆图片间的任意转换。
我们以NICE为例,介绍一下Flow-based Model的基本套路。
首先,\(G^{-1}\)必须是存在的且能被算出,这意味着G的输入和输出的维度必须是一致的并且G的行列式不能为0。因此,z和x的形状必须完全一致。
作为一个生成模型自然希望自己产生的数据的概率越高越好。因此这里的优化目标就是:
\[G^*=\arg \max_{G} \sum_{i=1}^m\log p_{G}(x^i)\]这里不加证明的给出结论:
\[\log p_{G}(x^i)=\log \pi(G^{-1}(x^i))+\log |det(J_{G^{-1}})|\]这里的第一项实际上就是\(\log \pi(z^i)\)。显然,当z为0时,正态分布的概率最大。
然而这会导致\(det(J_{G^{-1}})=0\),也就是第二项为\(-\infty\)。
所以z必须在两项之间平衡,才能得到最大值。这个平衡点就是我们的优化目标。
NICE采用了一种称为耦合层(Coupling Layer)的设计,如下图所示:
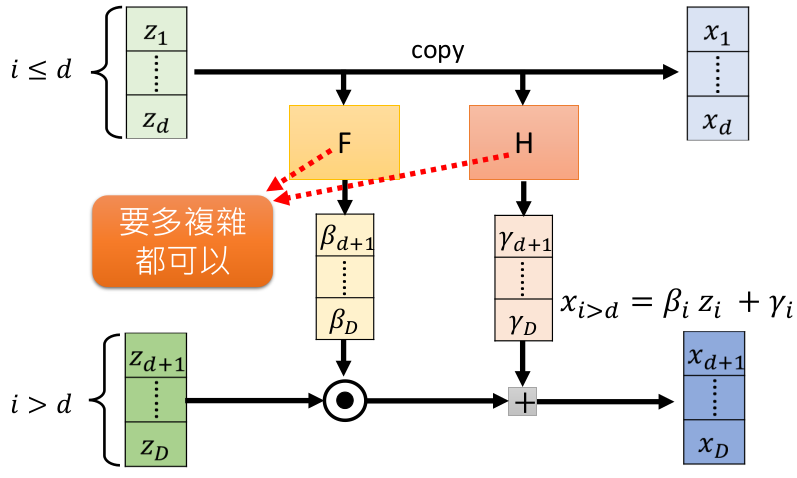
z和x都会被拆分成两个部分,分别是前1~d维和后d+1~D维。
z的1~d维直接复制(copy)给x的1~d维;z的d+1~D维分别通过F和H两个神经网络,通过仿射计算(affine)传递给x。
由于F和H的结果仅仅是系数,求偏导数的时候,会被当成常数,所以对于从\(G^{-1}\)构建G没有什么影响。
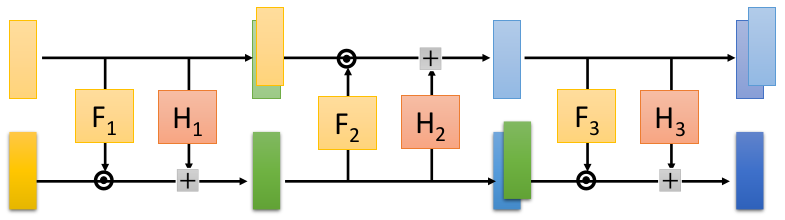
如果一层变换的表现力不足的话,我们也可以多做几层变换。需要注意的是,z的1~d维直接复制(copy)给x的1~d维的方式中的copy操作,对于生成模型的表现力会有影响。(总不可能生成图片的一部分还是随机噪声吧。)所以多层变换的话,需要使用交错的方式,组合copy操作和affine操作。
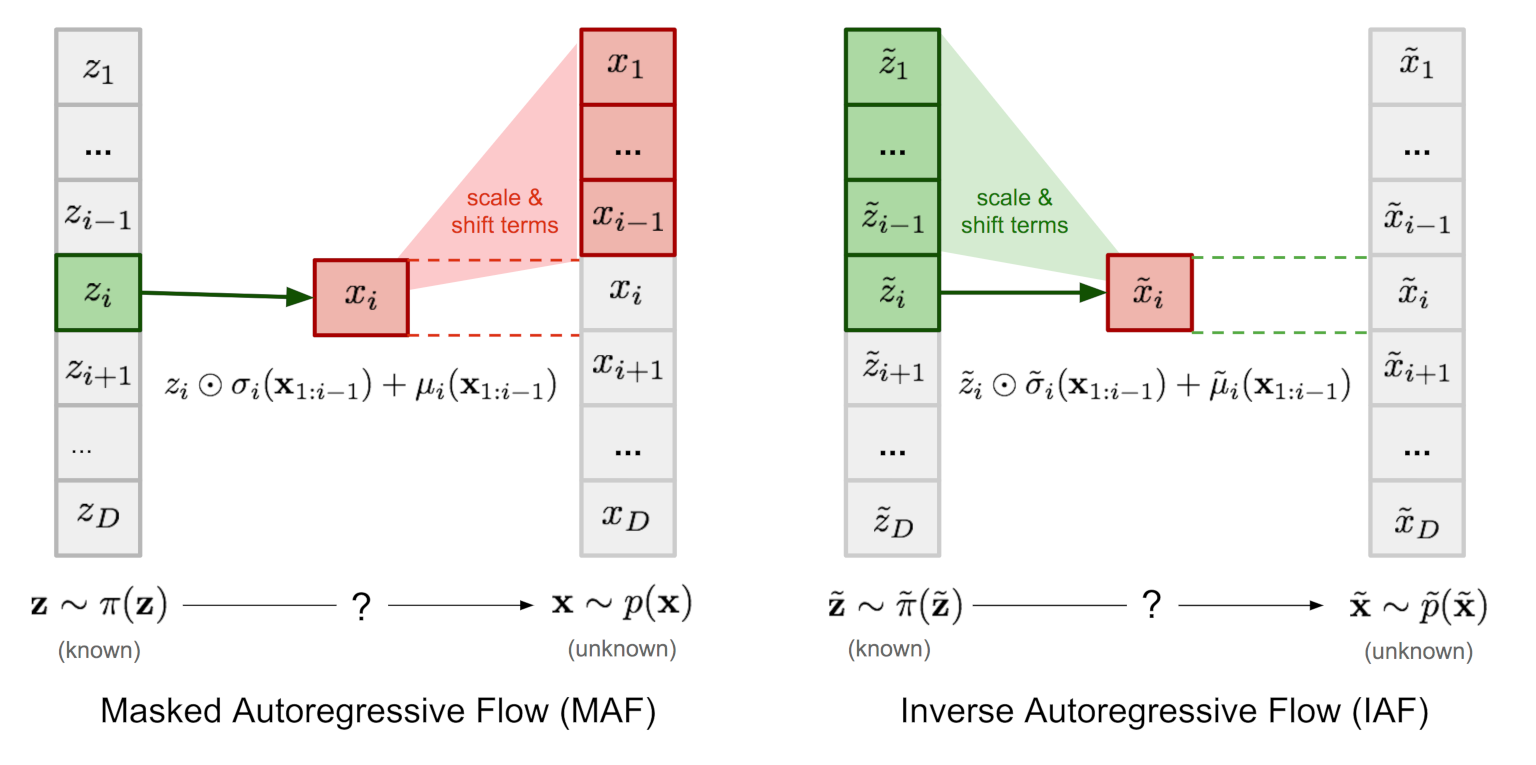
Masked Autoregressive Flow
Inverse Autoregressive Flow
参考:
https://zhuanlan.zhihu.com/p/44304684
Normalizing Flow小结
https://www.jianshu.com/p/66393cebe8ba
标准化流(Normalizing Flow)教程(一)
https://www.jianshu.com/p/db72c38233f3
标准化流(Normalizing Flow)(二):现代标准化流技术
https://mp.weixin.qq.com/s/oUQuHvy0lYco4HsocqvH3Q
Normalizing Flows入门(上)
https://mp.weixin.qq.com/s/XtlK3m-EHgFRKrtcwJHZCw
Normalizing Flows入门(中)
https://mp.weixin.qq.com/s/TRgTFBz_NmBJygQjOYwdqw
GAN/VAE地位难保?Flow在零样本识别任务上大显身手
https://mp.weixin.qq.com/s/xMO9jhzQH6P5NEA_D-uyIA
这个模型的脑补能力比GAN更强,ETH提出新型超分辨率模型SRFlow
https://zhuanlan.zhihu.com/p/351479696
基于流的生成模型-Flow based generative models
https://mp.weixin.qq.com/s/KrvW16GAxSGAPOCYYKbGUg
生成模型:标准化流(Normalized Flow)
https://lilianweng.github.io/posts/2018-10-13-flow-models/
Flow-based Deep Generative Models
Flow matching
ODE & SDE
ODE:常微分方程(Ordinary Differential Equation)
Flow matching是ODE框架:
- 起点:x0 = 随机噪声(高斯分布)
- 终点:x1 = 真实数据(图片/动作)
- 神经网络学的是速度场(Vector Field)f
- 推理时从噪声出发,按速度场用Euler或其他ODE求解器积分几步,就“流”到了数据。
特点:同样的噪声 → 同样的输出(确定性生成)。想要多样性就得换不同的噪声种子。
SDE:随机微分方程(Stochastic Differential Equation)
数学上,SDE在ODE的基础上加了一个随机项(通常是布朗运动/Wiener过程)。
DDPM/Diffusion Model的前向加噪过程就是一个SDE。
特点:天然多样性,但采样需要很多步(因为随机性让路径弯曲,需要小步长才能稳定)。
GLOW vs Flow matching
GLOW是离散可逆层式normalizing flow,而flow matching是连续流/CNF的免仿真训练法。前者靠“一层层可逆变换”把噪声映成数据,后者靠“一个时间相关速度场”用ODE把噪声流成数据。
Glow(Kingma & Dhariwal, 2018)的架构受限于“可逆+雅可比好算”,高分辨率图像要堆很多层,表达效率和扩展不如扩散/FFM。
Flow matching(Lipman 等 2022)面向Continuous Normalizing Flow(连续归一化流)对单个数据—噪声对定义条件路径,直接回归。训练不再解ODE,推理用Euler/Runge-Kutta解ODE,少步可采样。这里的步数N通常为2–4步,比DDPM的20步要少的多。
Conditional FM Loss:
\[\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{t \sim \mathcal{U}(0,1),\; x_1 \sim q,\; z \sim \mathcal{N}(0,I)} \left\| v_\theta(x_t, t) - (x_1 - z) \right\|^2\]参考
https://zhuanlan.zhihu.com/p/4116861550
通俗易懂的Flow Matching原理解读(附核心公式推导和源代码)
AIGC参考资源
https://mp.weixin.qq.com/s/H2nqQi2EVQ_EyeDNCRD3Cg
一文回顾AI绘画的成长之路:从简笔画到真实人脸生成
https://www.zhihu.com/question/583294094
Ai绘画半年了,到目前为止,AI绘画让多少画师失业了?未来又会有多少?
https://www.zhihu.com/question/584139316
AI绘画引入ControlNet,将会带来哪些影响?
https://www.zhihu.com/question/584053473
如何评价2023年2月AI绘画的最新水平?
https://mp.weixin.qq.com/s/HpziNAqHY9Oetsgk2AVxEg
ControlNet组合拳效果惊人,颠覆AI绘画游戏规则
https://zhuanlan.zhihu.com/p/615522634
AIGC的一些记录
https://www.zhihu.com/question/593770520
首批因AI失业的人来了,有公司已裁减原画师,导演陆川力赞AI海报高效优质,哪些职位容易被取代?
https://zhuanlan.zhihu.com/p/619730103
AI绘画教程:如何用Stable Diffusion始终画同一个人?
https://zhuanlan.zhihu.com/p/626335914
AI绘图StableDiffusion最强大模型盘点 - 诸神乱战
https://zhuanlan.zhihu.com/p/622914660
《Stable Diffusion 倚天剑术》第1卷:在各种设备上把Stable Diffusion玩起来
https://zhuanlan.zhihu.com/p/629348322
StableDiffusion LoRA自训练教程
https://mp.weixin.qq.com/s/DBLMAEbVw6v4xH94-5Zl3w
GAN逆袭归来!清华校友论文引爆AI绘图圈,一秒把大象P转身,Diffusion黯然失色
https://zhuanlan.zhihu.com/p/643872569
AI这样把NB写在脸上,它在玩一种很新的艺术
https://zhuanlan.zhihu.com/p/626004957
利用AI在独立游戏项目中大干快上
https://zhuanlan.zhihu.com/p/664461927
一天时间,我用AI做了一个恐龙网站
https://www.zhihu.com/question/15735401526
OpenAI GPT-4o推出原生图像生成功能,这次升级有哪些看点?
您的打赏,是对我的鼓励